고정 헤더 영역

상세 컨텐츠
본문
논문을 인용하는 AI 보고서 시스템을 만들 때는 검색, 보고서 생성, 검증을 각각 살펴봐야 합니다. AstaBrief 8B는 이 중 검색된 문헌을 보고서로 종합하는 부분에 특화된 공개 가중치 모델입니다.
Ai2의 2026년 10월 2일 발표를 바탕으로 입력 구조, 평가 결과, 내부 시스템에 연결할 때 필요한 조건을 정리합니다. 자료 확인일은 2026년 10월 4일입니다.
1. 검색 시스템과 생성 모델의 경계를 먼저 정합니다
Asta는 연구 지원 플랫폼이며 AstaBrief는 그 안의 Fast 모드에 사용되는 보고서 생성 모델입니다. 모델 파일을 받는 것과 플랫폼의 검색·문헌 접근 기능 전체를 확보하는 것은 별개입니다.
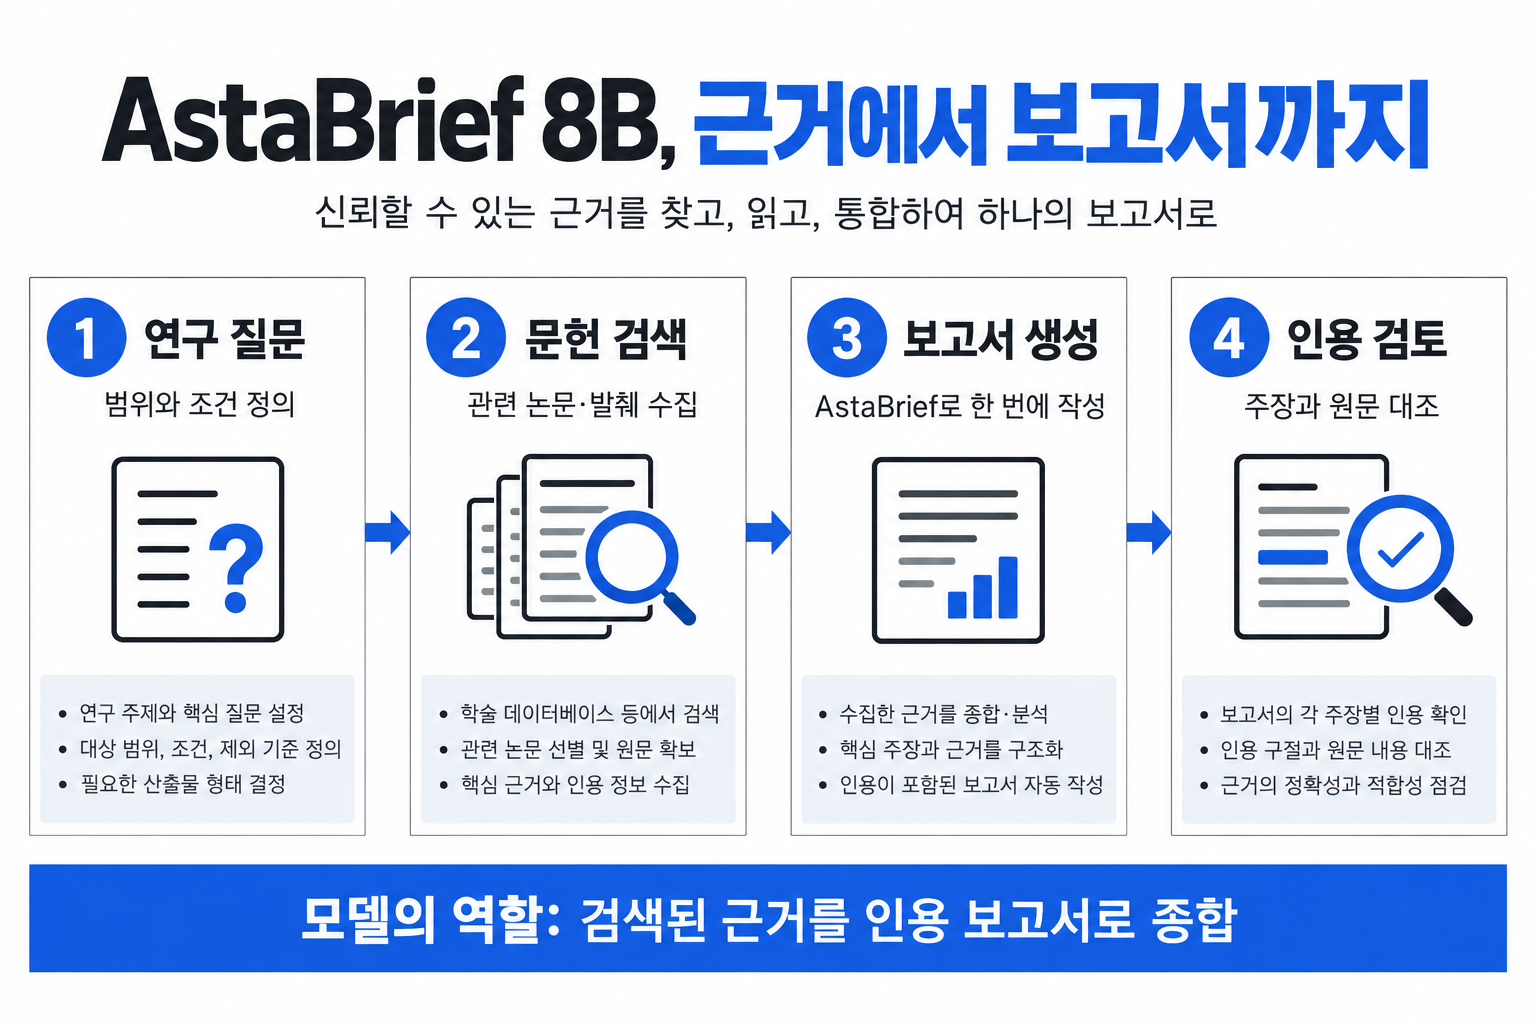
구축 시에는 질문에 맞는 문헌을 검색하고 발췌·출처 정보를 정리하는 계층이 필요합니다. 생성 모델에는 질문과 검색된 근거를 전달하고, 결과에서 각 주장의 인용 위치를 추적할 수 있게 연결합니다.
공식 모델카드는 학습에 사용한 권장 프롬프트 형식을 따르도록 안내합니다. 다른 대화 형식을 임의로 적용하기보다 해당 형식에 맞춰 입력을 구성하는 편이 출발점으로 적절합니다.
2. 빠른 생성은 처리 구조의 단순화에서 나옵니다
공식 발표의 전체 Asta 처리 과정에서 Fast 모드는 평균 51.1초, Thinking 모드는 178.5초였습니다. 약 3.5배 차이에는 모델 선택과 처리 구조 변경이 함께 반영됩니다.
Fast 과정은 검색된 발췌를 받아 한 번에 보고서를 작성합니다. 기존의 중간 요약·군집화·섹션별 생성 단계를 줄인 점이 핵심입니다. GPU에서의 순수 토큰 생성 속도나 모든 질문에서의 고정 지연시간으로 해석해서는 안 됩니다.
학습·평가 대부분은 2025년에 수행됐고 최신 최상위 모델과 전체 평가를 다시 진행하지 않았다는 설명도 있습니다. 이 결과는 보고서 시스템 설계의 효율성을 검토하는 근거로 읽는 것이 적절합니다.
3. 벤치마크에서는 인용과 내용 지표를 분리합니다
공식 모델카드의 CS2 테스트 100문항 결과에서 기반 Qwen3-8B와 AstaBrief를 비교하면 인용 정밀도는 76.2→90.5, 인용 재현율은 64.6→78.2입니다. 모두 높을수록 좋은 발표사 평가 점수이며 각각 14.3%포인트와 13.6%포인트 개선입니다.
답변 정밀도는 90.6→89.0으로 1.6%포인트 낮아졌습니다. 한 지표의 개선만으로 모든 업무에서 우수하다고 판단하기 어렵습니다. 테스트 질문의 분야와 문서 조건을 함께 확인해야 합니다.
학습은 Qwen3-8B 기반 SFT와 DPO로 진행됐습니다. Ai2가 인용 근거를 잘 갖춘 학습 예제를 선별한 접근은, 더 큰 모델만 선택하기보다 데이터 품질과 보고서 작성 절차를 점검할 필요성을 보여줍니다.
4. 내부 문서 보고서 시스템에 연결하는 방법
입력 자료를 선별하는 단계
예를 들어 내부 기술 검토 문서와 공개 논문을 함께 검색한다면 접근 권한을 먼저 적용하고, 문서 제목·작성일·발췌 위치를 유지합니다. 관련성이 낮거나 오래된 문서가 검색되면 생성 결과도 잘못된 방향으로 갈 수 있으므로 검색 결과를 별도로 평가합니다.
추적 가능한 보고서를 만드는 단계
문서 식별자를 발췌와 함께 전달하고, 보고서의 인용을 원본 문서와 연결합니다. 담당자가 클릭해 해당 문장을 확인할 수 있으면 오류를 찾고 수정하는 과정이 간단해집니다. 근거가 부족한 항목은 추가 검색이나 수동 조사로 이어지게 설계합니다.
실패를 처리하는 단계
검색 결과가 없거나 문헌끼리 결론이 충돌하면 그 상태를 보고서에 남깁니다. 생성된 문장의 근거 연결이 끊어지면 확정 보고서로 넘기기 전에 검토 대상으로 보냅니다. 권한이 없는 문헌을 근거로 결과를 반환하는지도 확인해야 합니다.
5. 검증 시간을 포함해 품질을 평가합니다
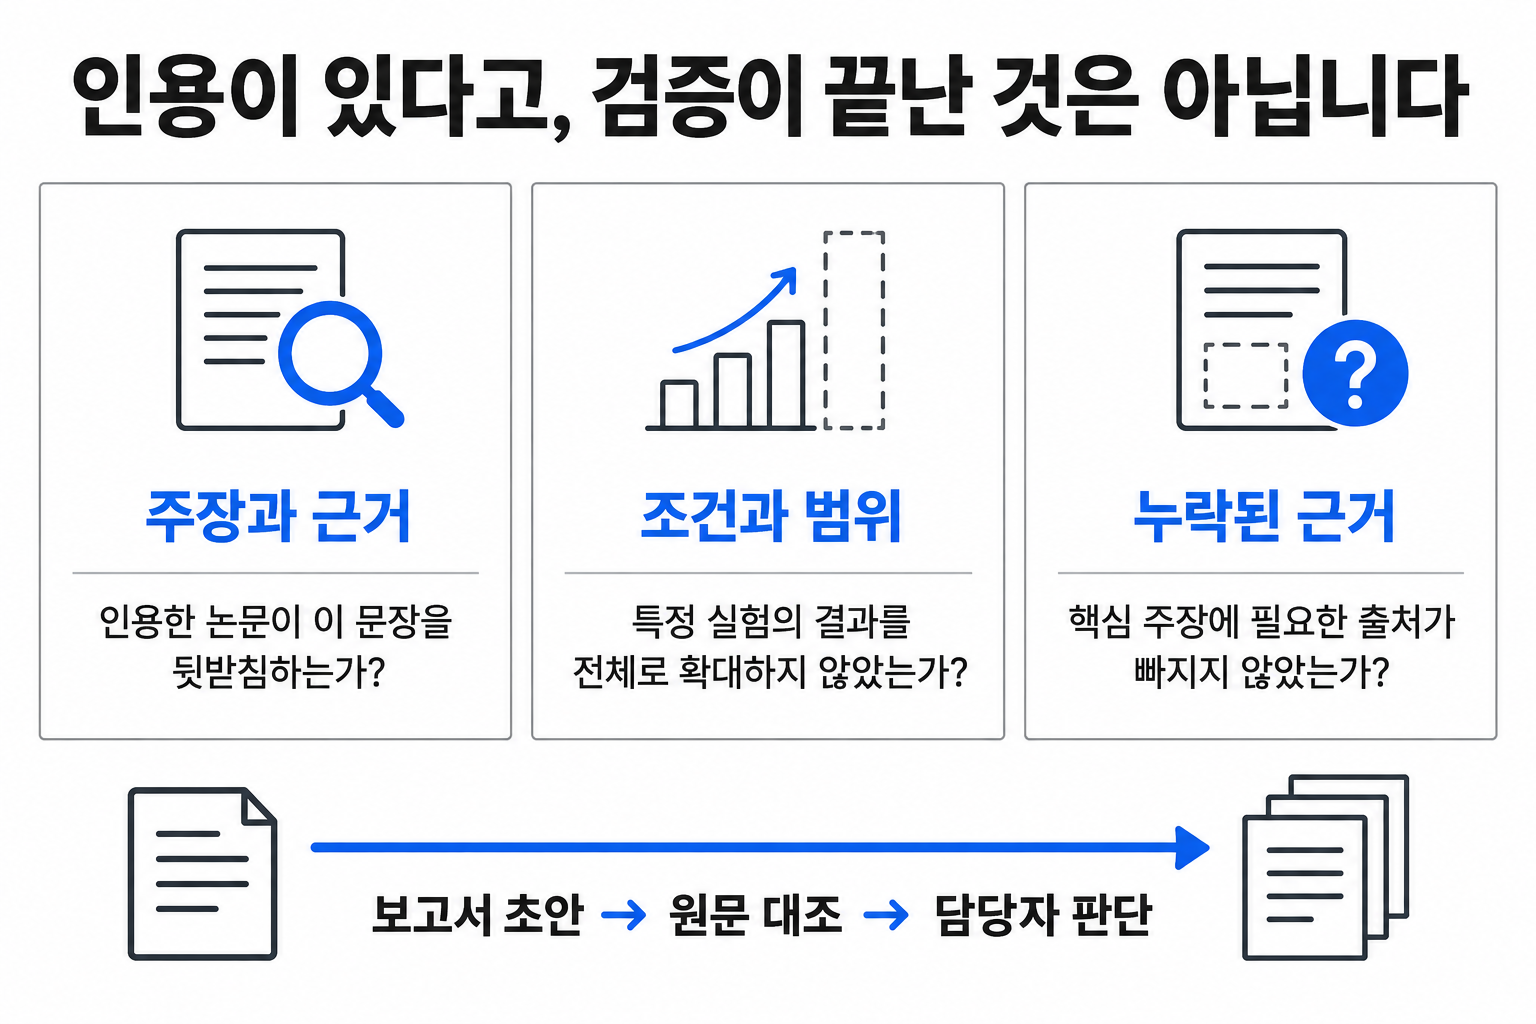
시범 운영에서는 담당자가 검토를 끝낸 질문·문헌 묶음으로 비교하는 것이 유용합니다. 초안 생성 시간과 함께, 검토 후 삭제한 주장·수정한 인용·추가로 찾은 근거를 기록하면 시스템의 실제 개선 지점을 찾을 수 있습니다.
특정 데이터셋의 결과를 회사 전체 환경으로 확대하는 문장처럼, 출처가 있어도 의미가 달라지는 오류를 포함해 평가하세요. 문헌의 날짜·장비·대상·제약 조건이 보고서에도 유지되는지 확인하는 과정입니다.
6. 자체 운영의 라이선스·언어·비용 조건
공식 모델카드는 Apache 2.0 라이선스와 영어 모델임을 안내합니다. 한국어 문헌의 전문 용어와 표·각주 처리는 실제 자료로 시험해야 합니다. 모델 가중치와 외부 검색 서비스·문헌·코드의 이용 조건은 각각 구분해 확인해야 합니다.
공개 가중치 운영에서도 GPU 메모리, 문맥 길이, 동시 요청, 검색·저장 시스템, 운영 인력의 비용이 발생합니다. 모델이 작다는 이유만으로 모든 환경에서 저렴하다고 단정하기보다, 검토까지 마친 보고서 한 건당 비용을 비교하는 것이 실용적입니다.
먼저 검토가 끝난 자료로 작은 범위의 보고서 업무를 평가하세요. 검색 품질과 근거 추적이 갖춰지면 AstaBrief의 빠른 초안 생성이 실제 업무 흐름에 도움이 되는지 판단할 수 있습니다.
공식 출처·모델·관련 자료
Ai2 — AstaBrief 공개 발표·공식 평가 도표
Ai2 — AstaBrief 8B 모델·평가·추론 안내
(주)제로원정보기술
AI 서비스 개발부터 GPU 서버 공급과 IT 인프라 구축까지 지원합니다.
주요 사업
AI 챗봇 · 내부 업무용 AI 서비스 · GPU 및 GPU 서버 공급 · 서버·클라우드 인프라 구축
상담 및 구축 문의
전화: 070-8095-9791
이메일: LCH@zerooneit.co.kr
본사: 경상북도 영천시 괴연1길 24-24, 경북테크노파크 하이브리드부품연구소 304-2호
지점: 대구광역시 수성구 알파시티1로 42길 11, 태왕알파시티수성 B동 1018호
'기술자료' 카테고리의 다른 글
| OpenAI Dots로 밤사이 업무 이어가기: 클라우드 실행·승인·실제 사례와 운영 방법 (0) | 2026.10.05 |
|---|---|
| Decision 2.0 Sol 2B·Vega 27B: 구조화된 판단 모델의 평가와 LLM 라우팅 설계 (0) | 2026.10.05 |
| CLM-8B와 Jev 비교: 행동 캐시·검증기 성능과 에이전트 운영 조건 (0) | 2026.10.02 |
| 왕의 귀환 Gemini 4 Argon, GPT-6 Astra·Claude Opus 5.5보다 가성비가 좋을까? (0) | 2026.10.02 |
| Meta Muse(메타 뮤즈)의 작동 방식과 실제 활용 사례: 개인 AI 에이전트가 주목받는 이유 (0) | 2026.10.01 |