고정 헤더 영역

상세 컨텐츠
본문
DeepSeek-V4.1-Flash-1017과 GPT·Claude 비교에서 먼저 분리할 것은 발표사 자체 평가와 외부 평가입니다. DeepSeek의 10월 17일 표는 GPT-5.6 Sol·Opus 5를, 이번에 확인한 독립 종합지수는 GPT-6.1 Sol·Opus 5.5를 비교할 수 있는 자료를 제공합니다.
이 글은 10월 18일의 출시·도입 소개에서 한 단계 더 나아가, 점수 차이와 하네스 조건을 실제 모델 선택 기준으로 읽습니다. 모든 모델이 같은 추론 예산으로 평가됐다고 가정하지 않습니다.
1. 모델 점수와 실행 환경을 함께 읽습니다
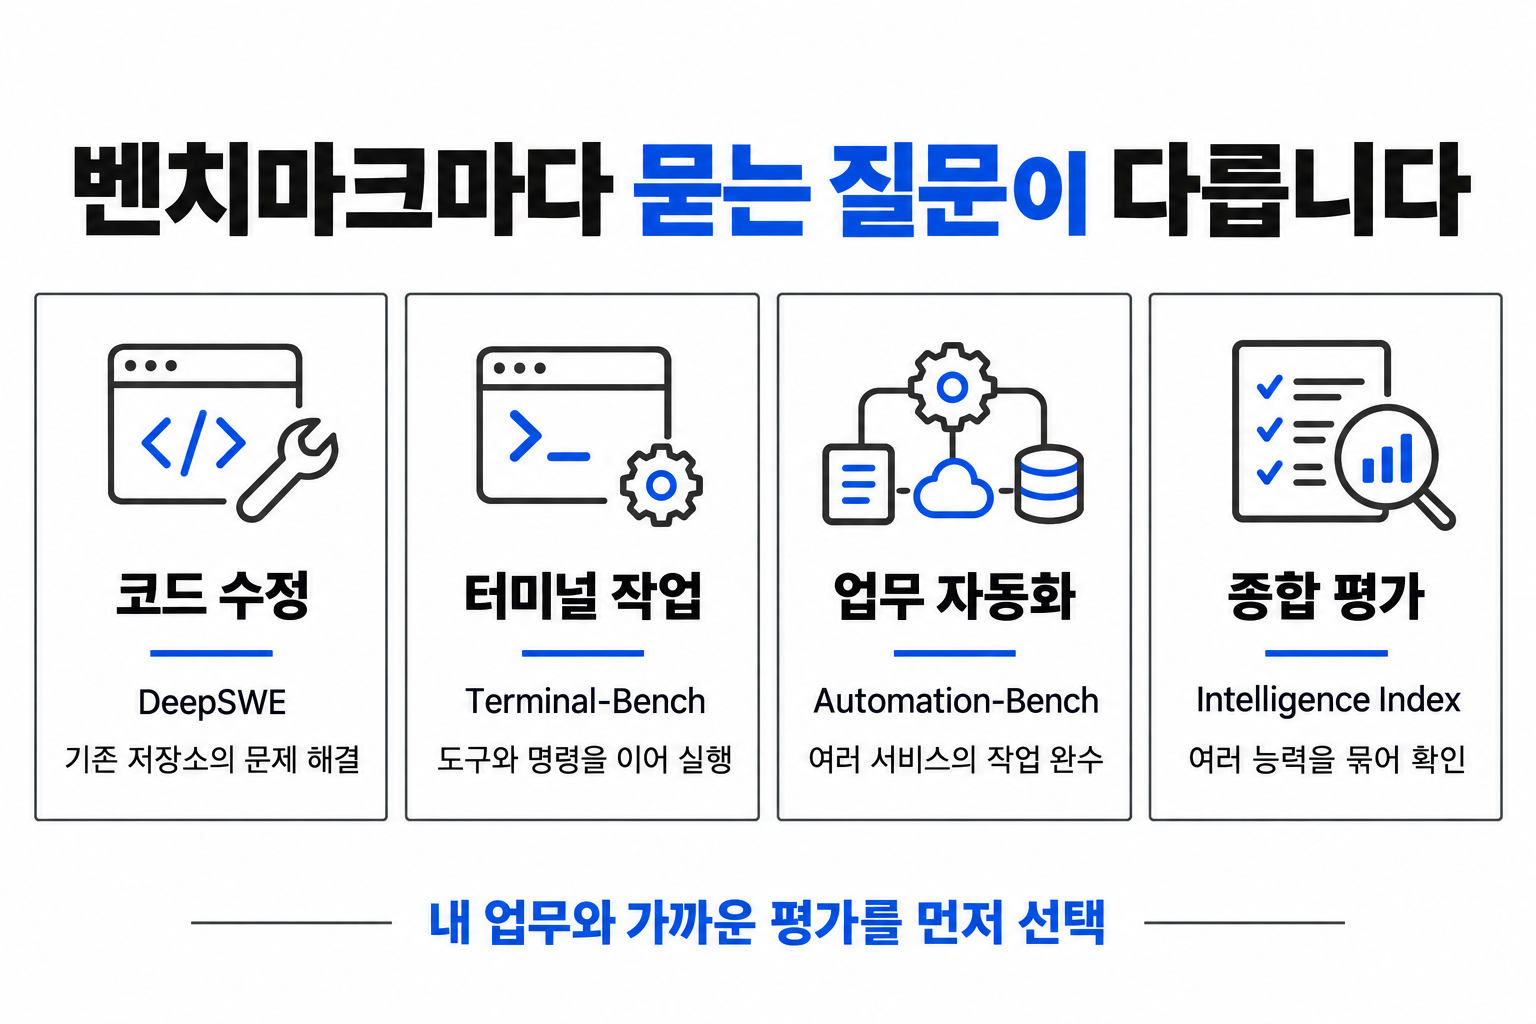
에이전트 평가는 모델만의 답변 시험과 다릅니다. 파일 접근, 터미널 도구, 실행 반복과 중간 상태를 다루는 하네스가 결과에 관여합니다. 같은 모델명이라도 도구와 실행 한도가 달라지면 업무 완주율을 그대로 옮길 수 없습니다.
DeepSeek 공식 모델 카드는 Terminal-Bench 4.0에 Claude Code, DeepSWE v1.1에 Mini-SWE-V2를 사용했다고 명시합니다. 벤치마크를 검토할 때는 버전뿐 아니라 어떤 작업과 도구를 묶어 평가했는지 먼저 확인해야 합니다.
2. GPT-5.6 Sol·Opus 5와 비교한 공식 원본
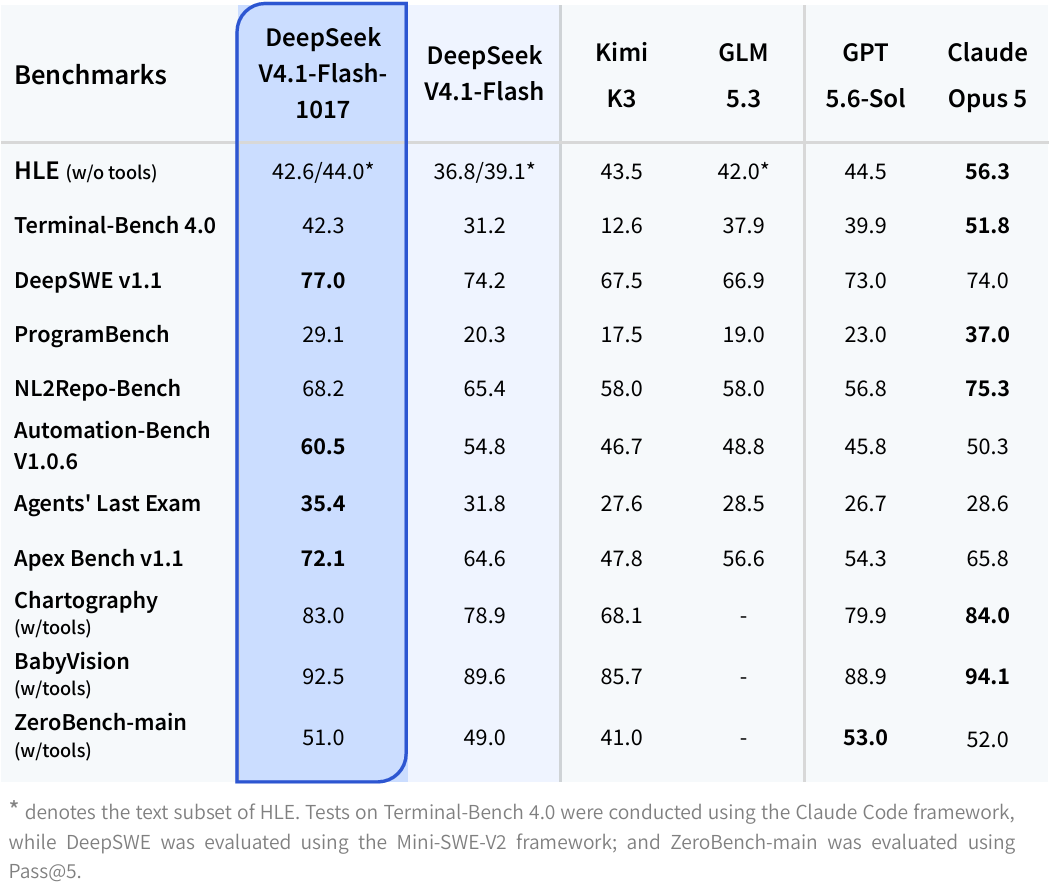
다음 원본은 DeepSeek 자체 발표입니다. DeepSWE v1.1의 77.0은 GPT-5.6 Sol 73.0보다 4.0%포인트, Opus 5의 74.0보다 3.0%포인트 높습니다. Automation-Bench v1.0.6의 60.5도 두 비교 모델을 앞섭니다.
승패가 반대인 항목도 있습니다. Terminal-Bench 4.0은 Opus 51.8, DeepSeek 42.3, GPT 39.9이고, ProgramBench는 Opus 37.0, DeepSeek 29.1, GPT 23.0입니다. 두 항목에서 GPT보다 높다고 해서 Claude보다도 높다고 쓸 수는 없습니다.
HLE 42.6과 텍스트 부분집합 44.0은 서로 다른 평가 범위입니다. 원본 하단은 ZeroBench-main을 Pass@5로 설명하므로 다른 항목의 한 번 성공률과 혼합하지 않습니다. 항목별 평가에서 높은 값이 유리하지만 서로 다른 단위를 합산한 종합 순위를 만들지 않습니다.
3. GPT-6.1 Sol·Opus 5.5는 독립 종합지수로 별도 확인
Artificial Analysis Intelligence Index v4.3.2는 10개 평가를 반영합니다. 2026년 10월 20일 공개 페이지 기준 DeepSeek 1017(Max)은 45점, GPT-6.1 Sol(High)은 50점, Claude Opus 5.5(High·Default Fallback)는 54점입니다. 지수는 높을수록 좋으며 백분율이 아닙니다.
공식 DeepSWE 결과와 이 지수가 다르게 보이는 이유는 측정 범위와 평가 주체가 다르기 때문입니다. 독립 종합지수에서 DeepSeek가 앞선다고 결론 내릴 수 없고, 반대로 그 차이만으로 특정 자동화 업무에서도 항상 불리하다고 판단할 수 없습니다.
Max와 High는 각 모델의 설정이며 동일한 토큰 예산이나 추론 시간이라는 뜻은 아닙니다. 확인한 페이지의 설정명과 날짜를 함께 남겨 결과의 범위를 좁혀 읽어야 합니다.
4. 배포 전 평가 과제를 세 가지로 나눕니다
저장소 수정 과제
수정 전 실패 테스트와 수정 후 통과 조건을 고정하고, 코드 차이와 회귀 오류를 확인합니다. 모델 답변에 “해결했다”는 문장이 있다는 이유만으로 성공 처리하지 않습니다.
여러 도구를 쓰는 사내 업무
읽기 권한의 자료로 먼저 검증하고 결과에 원문 위치와 처리 기록을 남깁니다. 자료 누락·잘못된 대상 선택·로그인 만료는 별도 실패 유형으로 기록합니다.
긴 프로젝트와 지식 판단 과제
중간 요구사항 변경과 모호한 입력을 포함해 보고, 최종 결과의 정확성과 사람이 개입한 횟수를 따로 셉니다. 코딩 수정 점수 하나로 전체 프로젝트 성능을 대체하지 않습니다.
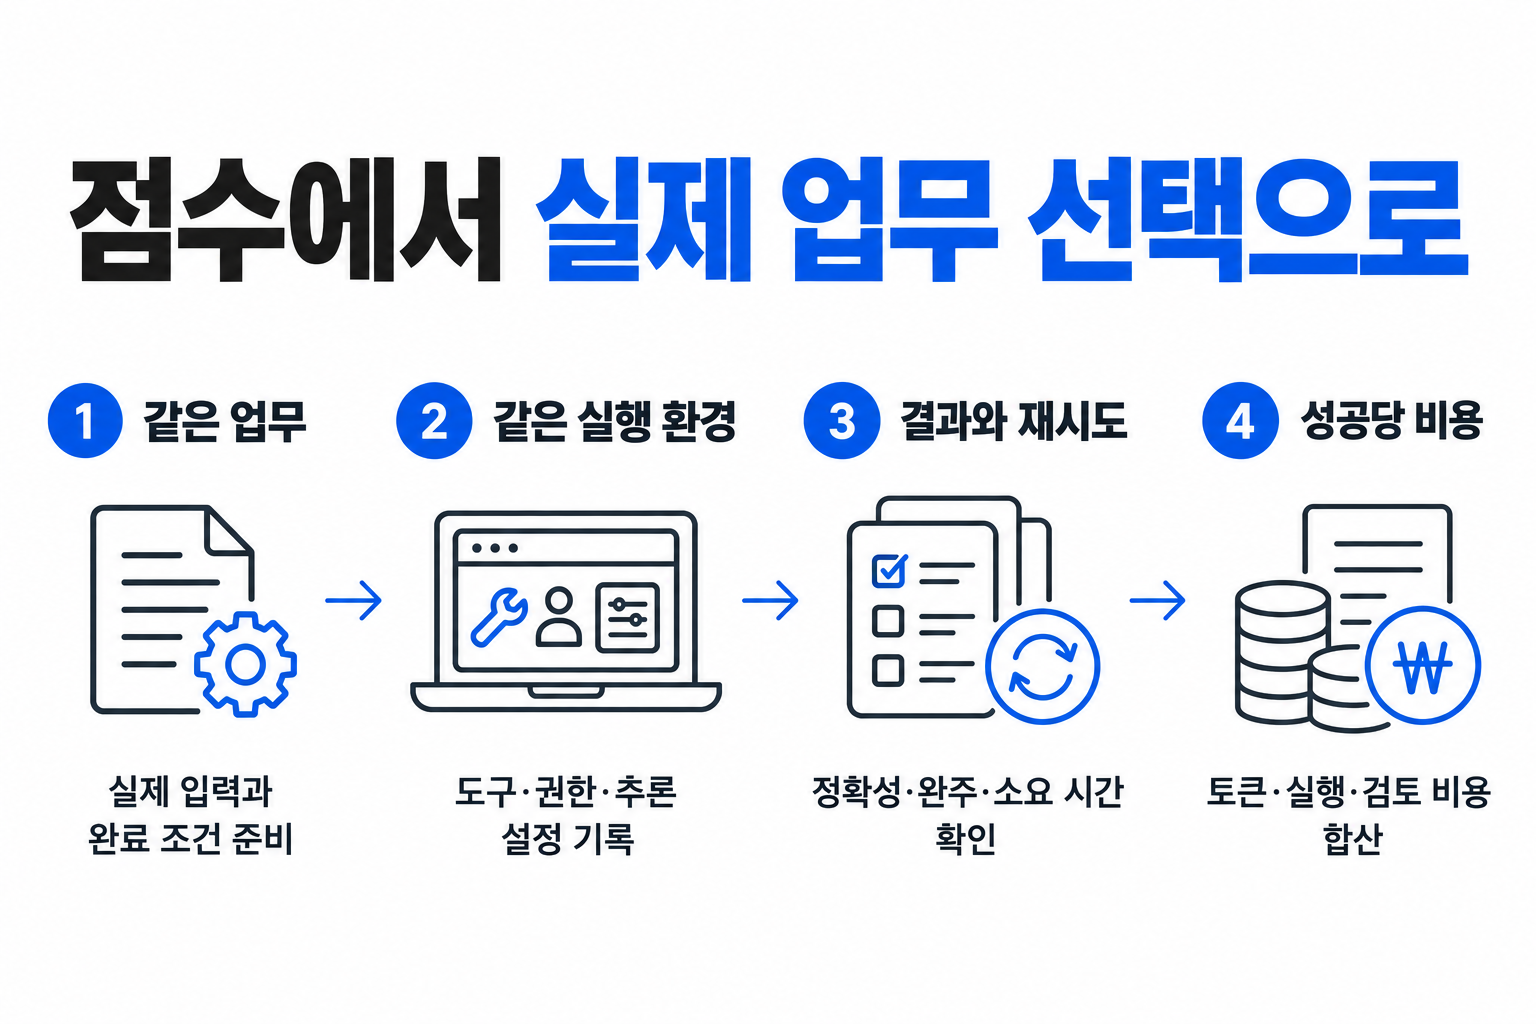
5. API 비용은 같은 완료 조건에서 계산합니다
DeepSeek의 API 안내는 현재 deepseek-flash가 1017 버전을 제공한다고 설명합니다. 운영에서는 호출 모델명과 제공 경로, 사용 시점, 도구 실행 환경을 기록해 버전 변경에 대비하는 것이 좋습니다.
비교 실험에서는 입력·캐시·출력·추론 토큰, 재시도, 외부 도구와 실행 서버, 검토 시간을 함께 기록합니다. 같은 업무를 끝낸 경우에만 성공당 비용을 비교하고 실패 건을 비용 계산에서 숨기지 않습니다.
6. 점수는 도입 후보를 고르는 근거입니다
이번 공개 자료는 DeepSeek 1017을 코딩 수정과 업무 자동화의 검증 후보로 삼을 근거를 줍니다. 다만 GPT·Claude와의 차이는 평가마다 달라지므로 전면 우위나 전면 대체를 단정하기 어렵습니다. 공식 표와 독립 지수를 분리하고 실제 과제의 성공 조건으로 최종 선택을 검증하세요.
공식 출처·독립 평가 자료
Artificial Analysis — DeepSeek (Max)
Artificial Analysis — GPT-6.1 Sol (High)
Artificial Analysis — Opus 5.5 (High) 비교
공식 원본 벤치마크 이미지의 권리자는 DeepSeek입니다. 원본의 모델명·주석·평가 조건을 유지했습니다. 발표일: 2026년 10월 17일 / 자료 확인일: 2026년 10월 20일.
(주)제로원정보기술
AI 서비스 개발부터 GPU 서버 공급과 IT 인프라 구축까지 지원합니다.
주요 사업
AI 챗봇 · 내부 업무용 AI 서비스 · GPU 및 GPU 서버 공급 · 서버·클라우드 인프라 구축
상담 및 구축 문의
전화: 070-8095-9791
이메일: LCH@zerooneit.co.kr
본사: 경상북도 영천시 괴연1길 24-24, 경북테크노파크 하이브리드부품연구소 304-2호
지점: 대구광역시 수성구 알파시티1로 42길 11, 태왕알파시티수성 B동 1018호
'기술자료' 카테고리의 다른 글
| Kumo Forecast 실무 가이드: DARR·시계열 입력·누수 없는 평가 방법 (0) | 2026.10.22 |
|---|---|
| Recursive Flint 로컬 코딩 모델: MoE 구조·벤치마크·도입 검증 가이드 (1) | 2026.10.22 |
| Mercury 3 확산형 LLM 분석: 생성 속도·API 요금·실제 적용 사례 (0) | 2026.10.20 |
| MiniMax M3.1 Flash API 가격과 벤치마크: 업무 성공당 비용으로 비교하기 (0) | 2026.10.20 |
| AgenticOS A2A 연동 가이드: 원격 에이전트 연결·인증·승인·비용 관리 (0) | 2026.10.19 |