고정 헤더 영역

상세 컨텐츠
본문
RTX 30 계열의 GPU Unlock 소식에서 가장 먼저 구분할 것은 연산 처리량과 실제 서비스 지연 시간입니다. GPU 내부의 계산이 빨라져도 모델 실행 전체의 병목이 그대로라면 사용자가 체감하는 변화는 작을 수 있습니다.
이 글에서는 개발자 원문을 기준으로 변경 대상, 공개 측정 조건, 이미지·영상 생성과 LLM 서비스의 차이를 정리합니다. NVIDIA 공식 드라이버의 기능 추가가 아닌 커뮤니티 프로젝트라는 점부터 확인해야 합니다.
1. 변경되는 것은 특정 연산의 발행 속도입니다
원 개발자는 Linux 커널 모듈을 이용해 NVIDIA 드라이버가 장치를 점유하기 전에 연산 관련 설정을 바꾸는 구조를 설명합니다. 일반적인 응용프로그램 옵션 하나를 켜는 것과는 적용 지점이 다릅니다.
문서의 초점은 FP16·BF16 입력으로 계산하고 FP32로 누산하는 연산입니다. 지원 대상으로 언급된 GPU 칩과 실제 보드, 사용 중인 드라이버·커널을 대조해야 하며 카드 이름만 보고 동작을 확정할 수는 없습니다.
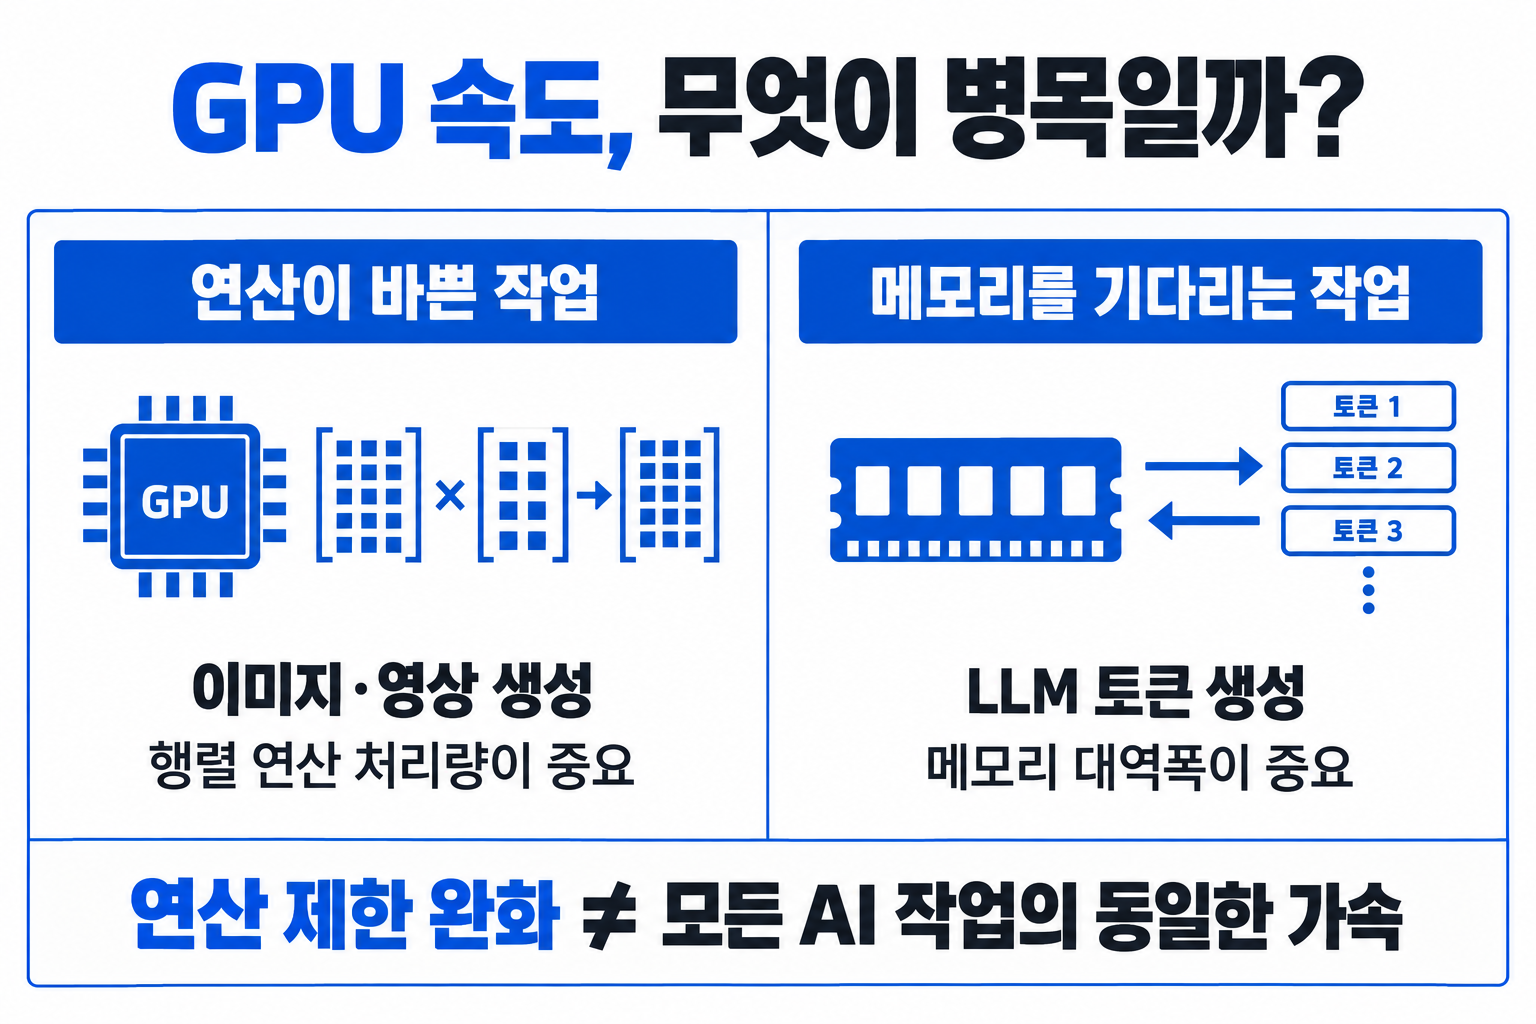
LLM에서도 입력 처리(prefill)와 출력 생성(decode)은 요구 자원이 다릅니다. 특히 작은 배치의 토큰 생성은 메모리 병목이 커질 수 있고, 큰 배치·다른 엔진에서는 연산 비중도 달라집니다.
2. RTX 3090 Ti 결과를 읽는 기준
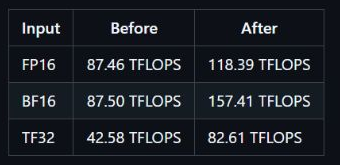
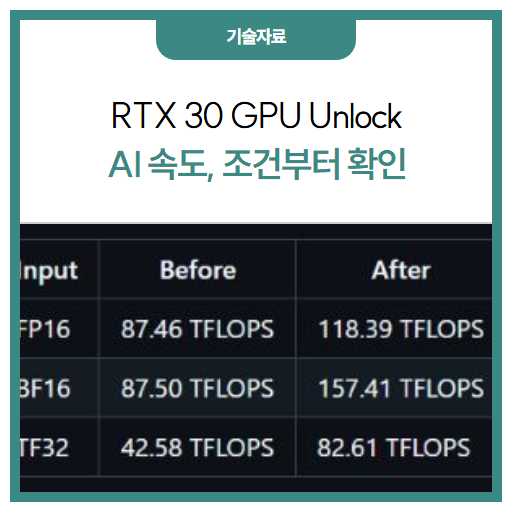
개발자 README에는 RTX 3090 Ti의 8192³ GEMM 결과가 제시돼 있습니다. 조건은 450W 전력 한도·FP32 누산·5회 중앙값이며, 단위는 TFLOPS입니다. 아래는 이 표의 실제 원문 화면입니다.
BF16의 157.41÷87.50은 약 1.80배입니다. FP16은 같은 표에서도 변화 폭이 다릅니다. 연산 형식별 결과가 다른데 이를 “모든 AI가 같은 비율로 빨라진다”로 합쳐 해석할 수는 없습니다.
원 이슈에는 초기 실험 구성과 이후 주 저장소 반영 과정이 기록돼 있습니다. 원문 표의 시험 환경을 현재 패키지를 설치했을 때의 보장 결과로 바꾸어 읽지 않는 것이 중요합니다.
3. 서비스에서는 구간별로 시간을 나눠 재야 합니다
이미지·영상 파이프라인
모델 추론 구간뿐 아니라 입력 파일 읽기, CPU 후처리, 저장과 인코딩까지 시간을 구분합니다. 같은 생성 모델·정밀도·해상도·단계 수를 유지하고 워밍업 뒤 반복 측정하면 비교 조건을 통제하기 쉽습니다.
사내 LLM·RAG 서비스
문서 검색 지연과 모델의 첫 토큰까지 걸린 시간, 이후 토큰 처리량을 분리합니다. 검색 시스템이 느린 경우 GPU 연산 최적화만으로 직원의 대기 시간이 충분히 줄지 않을 수 있습니다. 동시 요청 수와 입력·출력 길이도 같은 기준으로 맞춰야 합니다.
콘텐츠 제작 업무
담당자가 시안을 요청하고 AI가 결과를 만들면, 최종 선택 전에 제품 형태·텍스트·장면 일관성을 검토합니다. 실패 시 재생성 시간을 포함해야 하므로, 한 번의 빠른 실행보다 실제 채택한 이미지나 영상 한 건당 시간을 비교하는 편이 실무적입니다.
4. 재현 가능한 검증을 위한 흐름
같은 프롬프트·모델 버전·정밀도·배치 조건으로 전후 결과를 남깁니다. 최저 시간 하나 대신 중앙값과 편차를 비교하고 장시간 구동에서 실패가 늘지 않는지도 살펴봅니다. 아래 흐름은 업무 적용을 위한 검증 순서입니다.
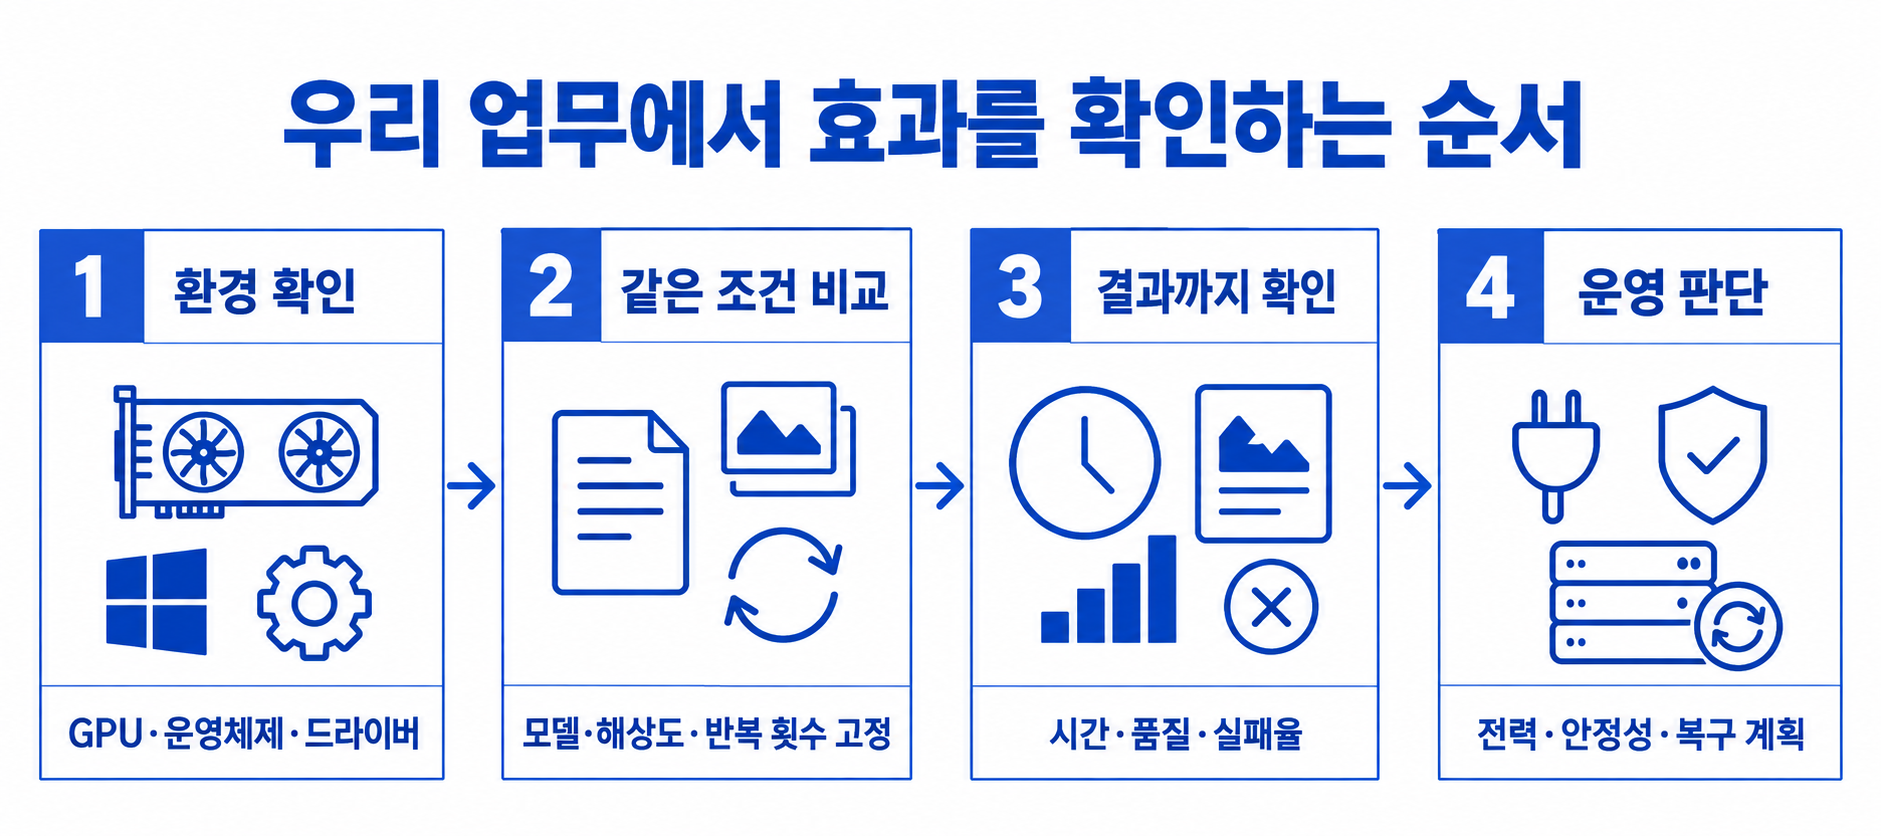
5. 배포와 장비 선택은 따로 판단합니다
원 프로젝트의 중심은 Linux이며 Windows는 별도 포트로 소개됩니다. 포트의 존재만으로 지원 품질이 동일하다고 볼 수 없으므로 실제 환경과 유지보수 범위를 확인해야 합니다. 부팅 초기 단계에 관여하는 만큼 시험 장비에서 재현한 뒤 운영 적용 여부를 판단하는 편이 타당합니다.
GPU Unlock은 VRAM을 늘리거나 데이터센터 GPU의 모든 기능을 제공하는 도구가 아닙니다. 큰 모델 적재가 목적이라면 메모리 용량, 동시 사용자가 많다면 대역폭·추론 엔진·배치 구성을 먼저 검토할 필요가 있습니다.
운영에서 남길 기록
적용한 버전과 환경, 전후 측정값, 정상 결과물 수, 오류 로그, 복구 절차를 남겨야 이후 업데이트 때도 같은 기준으로 비교할 수 있습니다. 성능 이득이 유지보수 비용을 넘어서는지가 최종 판단 기준입니다.
기존 장비의 잠재력을 확인하는 기술로는 흥미롭지만, 효율을 결정하는 것은 장비의 이름보다 실제 작업의 병목입니다. 이미지 생성과 문서 챗봇을 같은 수치로 평가하지 않고, 서비스 단위로 측정하는 접근이 필요합니다.
공식 자료·원문
Zagitta — GPU Unlock 개발자 저장소와 README
NVIDIA — LLM 추론의 prefill·decode와 메모리 병목
AI타임스 — RTX 30 GPU Unlock 관련 보도, 10월 26일
비교 도표: Zagitta/gpu-unlock 개발자 README의 원본 표 화면 인용. NVIDIA의 공식 성능 발표가 아닙니다. 자료 확인: 2026년 10월 27일.
(주)제로원정보기술
AI 서비스 개발부터 GPU 서버 공급과 IT 인프라 구축까지 지원합니다.
주요 사업
AI 챗봇 · 내부 업무용 AI 서비스 · GPU 및 GPU 서버 공급 · 서버·클라우드 인프라 구축
상담 및 구축 문의
전화: 070-8095-9791
이메일: LCH@zerooneit.co.kr
본사: 경상북도 영천시 괴연1길 24-24, 경북테크노파크 하이브리드부품연구소 304-2호
지점: 대구광역시 수성구 알파시티1로 42길 11, 태왕알파시티수성 B동 1018호
'기술자료' 카테고리의 다른 글
| Devin Security 2.0 운영 가이드: 위협 모델·재현 환경·수정 PR 검토 기준 (0) | 2026.10.29 |
|---|---|
| Siri AI 한국어 베타 활용 가이드: iOS 27.2 지원 기기·설정·업무 접근 범위 (0) | 2026.10.28 |
| PhoneUse MCP 연동 가이드: 모바일 에이전트의 지원 범위·화면 관찰·실행 검증 (0) | 2026.10.26 |
| Nemotron 3.5 Bolt E4B 도입 가이드: 메모리·벤치마크·추론 설정과 업무 적용 (0) | 2026.10.26 |
| Kimi K3.1 Pro 도입 가이드: 벤치마크 조건·API 요금·Code 설정·가중치 공개 일정 (0) | 2026.10.25 |