고정 헤더 영역

상세 컨텐츠
본문
사내 AI 서비스에서 비용과 운영 부담을 만드는 것은 긴 답변 생성만이 아닙니다. 요청을 분류하고, 검색된 근거를 고르고, 다음 처리 경로를 정하는 판단도 반복됩니다. 이번 기술자료에서는 TypeSafe AI의 Jev를 이런 단계에 넣는다면 무엇을 설계하고 검증해야 하는지 살펴봅니다.
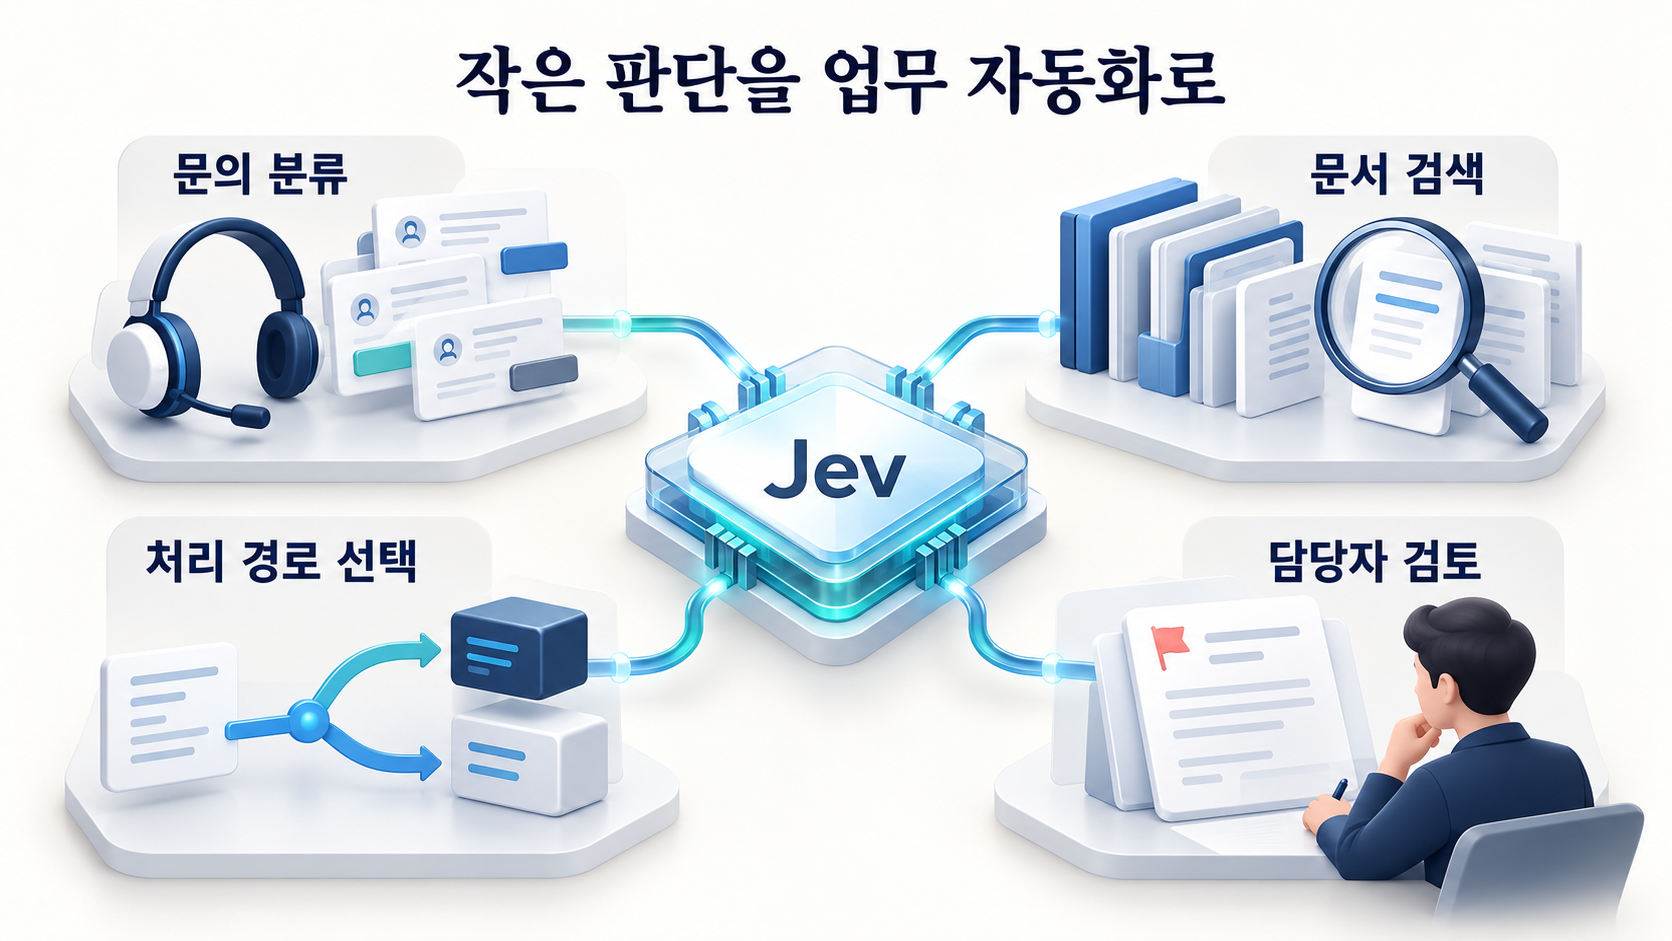
[이미지 설명] 분류와 검색, 처리 경로 선택을 담당자 검토와 연결한 AI 제작 개념 이미지입니다. 실제 구축 화면이 아닙니다.
1. 먼저 ‘판단’과 ‘실행’을 나눕니다
Jev는 주어진 상태(state)와 질문을 받아 정해진 형태의 결과를 반환하는 모델입니다. 새 문장을 생성하는 대신 선택·평가·조건 판단을 수행합니다. TypeSafe AI는 이를 System One 모델이라고 소개합니다.
설계자가 정해야 할 것은 세 가지입니다. 모델에 어떤 정보를 보여줄지, 어떤 질문을 맡길지, 결과를 받은 프로그램이 무엇을 할지입니다. “알아서 업무를 처리해줘”처럼 넓은 지시보다 작은 판단을 정의하고 후속 처리를 코드로 묶는 구성이 어울립니다.
2. 문의 접수 업무를 예로 들면
가상의 문의 접수 시스템을 생각해보겠습니다. 접수 내용에서 업무 분야를 고르고, 추가 확인이 필요한지 판단한 뒤, 확신이 부족한 건은 담당자 검토로 보냅니다. 아래는 설계 예시로, 실제 Jev 호출 결과나 당사 운영 사례가 아닙니다.
| 단계 | 판단 또는 처리 | 담당 역할 |
| 입력 정리 | 질문에 필요한 문의 내용과 문맥만 준비 | 프로그램 |
| 분야 분류 | 미리 정한 업무 분야 중 선택 | Jev Choice |
| 조건 확인 | 별도 검토가 필요한 조건인지 평가 | Jev Noul 등 |
| 결과 처리 | 기준에 따라 연결·보류·사람 검토 | 프로그램과 담당자 |
중요한 것은 ‘기타·추가 확인’ 경로를 남겨두는 일입니다. 선택지가 잘못 나뉘면 어떤 모델을 사용해도 원하는 업무 결과를 얻기 어렵습니다. 실제 접수 사례를 보고 담당자가 구분할 수 있는 기준부터 작성하는 것이 좋습니다.
3. RAG에서는 검색 결과와 답변 사이에 놓습니다
문서 검색 결과에 비슷한 표현이 있다고 해서 모두 좋은 답변 근거가 되는 것은 아닙니다. Jev를 적용한다면 검색한 문서별로 ‘질문과 관련 있는가’, ‘답변에 쓸 근거를 포함하는가’ 같은 판단을 요청하고 프로그램이 사용할 문서를 고를 수 있습니다.
TypeSafe의 공식 예제도 검색 문서를 평가한 뒤 근거와 상충 정보를 나누어 생성 모델에 전달하는 흐름을 다룹니다. 우리 서비스에서는 최신 문서 여부나 사용자의 열람 권한처럼 별도로 확인할 조건을 함께 설계해야 합니다. 문서 평가 모델 하나로 답변 품질 전체가 보장되지는 않습니다.
4. 출력 형식은 업무 질문에 맞춰 고릅니다
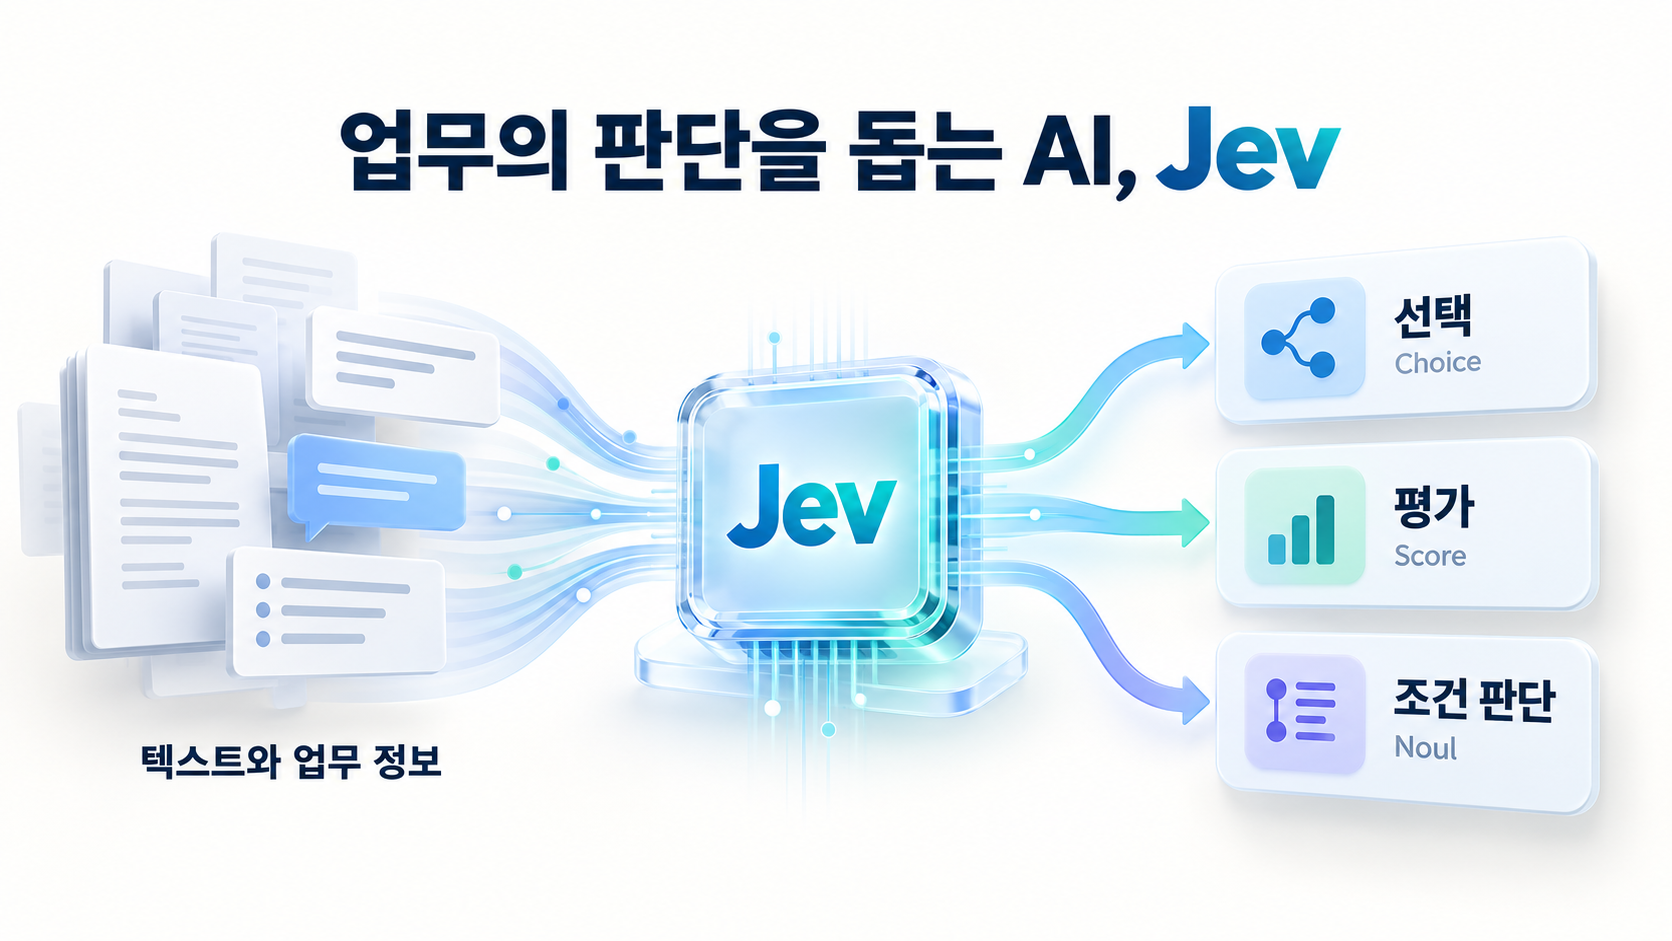
[이미지 설명] Choice·Score·Noul의 역할을 표현한 AI 제작 개념도입니다. 그림 속 카드들은 텍스트·업무 상태를 상징합니다.
Choice는 후보 중 하나를 선택할 때, Score는 설명된 순서형 등급으로 평가할 때 적합합니다. Noul은 특정 명제에 대한 ‘예’의 확률을 0~1로 받는 방식입니다. 점수의 숫자만 정하기보다 각 등급이 어떤 상태를 뜻하는지 설명해야 합니다.
Choice와 Score의 confidence는 확률 분포를 요약한 지표이며, Noul에는 별도의 confidence 필드가 없습니다. 두 값을 같은 의미로 취급해 동일한 기준을 기계적으로 적용하지 않는 것이 좋습니다.
5. 실제 도입 판단은 네 가지를 함께 측정합니다
정확도와 오류 유형 — 전체 정답률뿐 아니라 어떤 문의가 엉뚱한 분야로 갔는지 살펴봅니다. 쉬운 문장만 모으지 말고 한국어 약어, 복합 문의, 정보가 부족한 문장을 포함합니다.
자동 처리 비율과 검토량 — 기준을 엄격하게 하면 자동 처리되는 건수가 줄 수 있습니다. 틀린 자동 처리의 비용과 사람이 검토할 수 있는 양을 함께 고려해야 합니다. 기준을 조정한 데이터와 최종 성능을 평가할 데이터도 구분하는 편이 좋습니다.
응답 시간과 장애 대응 — 한국에서 호출할 때의 지연, 동시 요청, 실패·재시도까지 포함해 측정합니다. API가 응답하지 않을 때 기본 처리 경로나 검토 대기열로 넘길 방법을 준비합니다.
최종 업무 한 건의 비용 — 입력 토큰 가격 외에도 반복 호출과 후속 생성 모델, 운영·검토 비용이 들어갑니다. 같은 입력으로 기존 규칙·분류기·LLM 방식과 비교해야 Jev를 추가할 이유가 분명해집니다.
위 네 가지는 실제 적용을 위한 검토 제안입니다. 이 글에서 직접 성능 실험을 수행한 것은 아닙니다.
6. 자주 생기는 오해와 적용 범위
구조가 맞는 답과 사실이 맞는 답은 다릅니다. 정해진 선택지로 결과가 나온다고 판단 자체가 항상 옳은 것은 아닙니다. 공식 Jev 1.13 문서도 계산·날짜 비교·복잡한 간접 추론과 악의적인 입력을 약점으로 다룹니다. 권한 검증과 정확한 계산은 프로그램에 남겨두어야 합니다.
API 도입과 로컬 모델 구축도 다릅니다. 공식 빠른 시작은 Playground와 호스팅 API를 안내합니다. SDK를 설치한다고 모델이 내부 서버에서 실행되는 것은 아닙니다. 기관의 내부 자료를 다루는 경우 외부 전송과 이용 조건을 검토한 뒤 적용 범위를 정해야 합니다.
공개된 배수만으로 예산을 산정하지 않습니다. 2026년 9월 30일 공식 요금 안내는 입력 100만 토큰당 0.042달러이며 출시 안내상 출력 토큰은 무료입니다. 회사가 발표한 큰 속도·비용 개선 배수에는 평가 조건이 있으므로, 실제 적용 효과는 자체 측정으로 확인해야 합니다. 가격과 제공 조건은 변경될 수 있습니다.
작게 시작한다면 고객지원 문의 분류나 문서 관련성 평가처럼 결과를 검토하기 쉬운 업무가 후보가 될 수 있습니다. 전자상거래 문의 처리, IT 장애 접수 분류, AI 모델 선택에도 같은 설계 방식을 응용할 수 있습니다. 이는 활용 가능성에 대한 제안이며 도입 성과를 보장하지 않습니다.
제로원정보기술은 AI 서비스 개발과 AI 인프라 공급·구축을 수행합니다. 앞으로 기술자료 카테고리에서 새로운 기술의 특징뿐 아니라 실제 서비스에 연결할 때 필요한 검토 관점도 소개하겠습니다.
작성 기준: 2026년 9월 30일 공식 공개 자료. 본문 사례는 설명을 위한 설계 예시이며 직접 측정한 벤치마크가 아닙니다.
(주)제로원정보기술
전화: 070-8095-9791
이메일: LCH@zerooneit.co.kr
본사: 경상북도 영천시 괴연1길 24-24, 경북테크노파크 하이브리드부품연구소 304-2호
지점: 대구광역시 수성구 알파시티1로 42길 11, 태왕알파시티수성 B동 1018호
'기술자료' 카테고리의 다른 글
| 왕의 귀환 Gemini 4 Argon, GPT-6 Astra·Claude Opus 5.5보다 가성비가 좋을까? (0) | 2026.10.02 |
|---|---|
| Meta Muse(메타 뮤즈)의 작동 방식과 실제 활용 사례: 개인 AI 에이전트가 주목받는 이유 (0) | 2026.10.01 |
| GPT-6.1 Sol과 GPT-6 Astra 비교: 벤치마크 점수·토큰 비용·Low부터 Ultra까지 (0) | 2026.10.01 |
| OpenAI Agents API Computer Use와 Aside·Claude·Browser Use: 실행 환경과 활용 사례 비교 (0) | 2026.10.01 |
| Claude Sonnet 5.5, GPT-6.1 Astra 뉴스로 보는 AI 도입 기준: 비용과 실행 권한 (0) | 2026.09.30 |