고정 헤더 영역

상세 컨텐츠
본문
로컬 LLM 서버를 준비할 때는 GPU의 이름만큼이나 ‘어떤 모델을, 몇 명이, 얼마나 긴 문서와 함께 사용할 것인가’가 중요합니다. 같은 GPU를 사용하더라도 운영 조건에 따라 필요한 메모리와 서버 구성이 달라지기 때문입니다.
(주)제로원정보기술은 OO시청의 내부 업무용 로컬 LLM 구동을 위해 국산 KTNF KH590S3 서버에 NVIDIA RTX PRO 6000 96GB GPU 2대를 장착해 납품했습니다. 이번 글에서는 이 구성을 예로 들어 GPU 메모리, CPU와 저장장치, 향후 확장을 살펴보겠습니다.
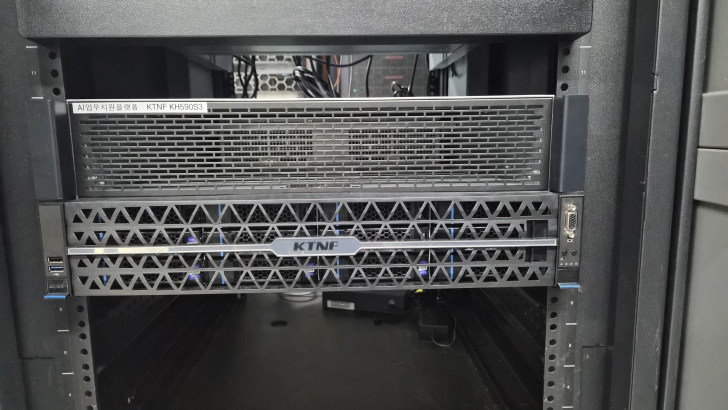
[이미지 설명] OO시청 내부 업무용 AI 인프라로 납품한 KTNF KH590S3의 랙 설치 모습
1. 96GB VRAM을 볼 때 함께 확인할 것
GPU 메모리는 AI 모델의 가중치를 올리는 공간이면서, 추론 과정에서 필요한 데이터도 담는 공간입니다. 따라서 모델 파일 크기만 확인하고 GPU 용량을 결정하기보다 입력 문서의 길이와 동시 처리량까지 함께 검토하는 것이 좋습니다.
예를 들어 긴 문서를 참조하며 대화할 때는 이전 토큰의 계산 결과를 재사용하는 KV 캐시가 메모리를 차지합니다. 모델의 구조와 캐시 방식에 따라 차이가 있지만, 긴 문맥을 다룰수록 이 공간이 중요한 검토 항목이 됩니다.
이번에는 GPU 1대당 96GB VRAM을 갖춘 RTX PRO 6000을 선택했습니다. NVIDIA가 안내하는 RTX PRO 6000 Blackwell Server Edition은 96GB GDDR7 ECC 메모리를 제공하며, LLM 추론을 활용 분야로 제시합니다. 필요한 모델과 예산이 맞는다면 내부 업무용 AI 서버의 비용 대비 활용도를 검토할 만한 선택지입니다.
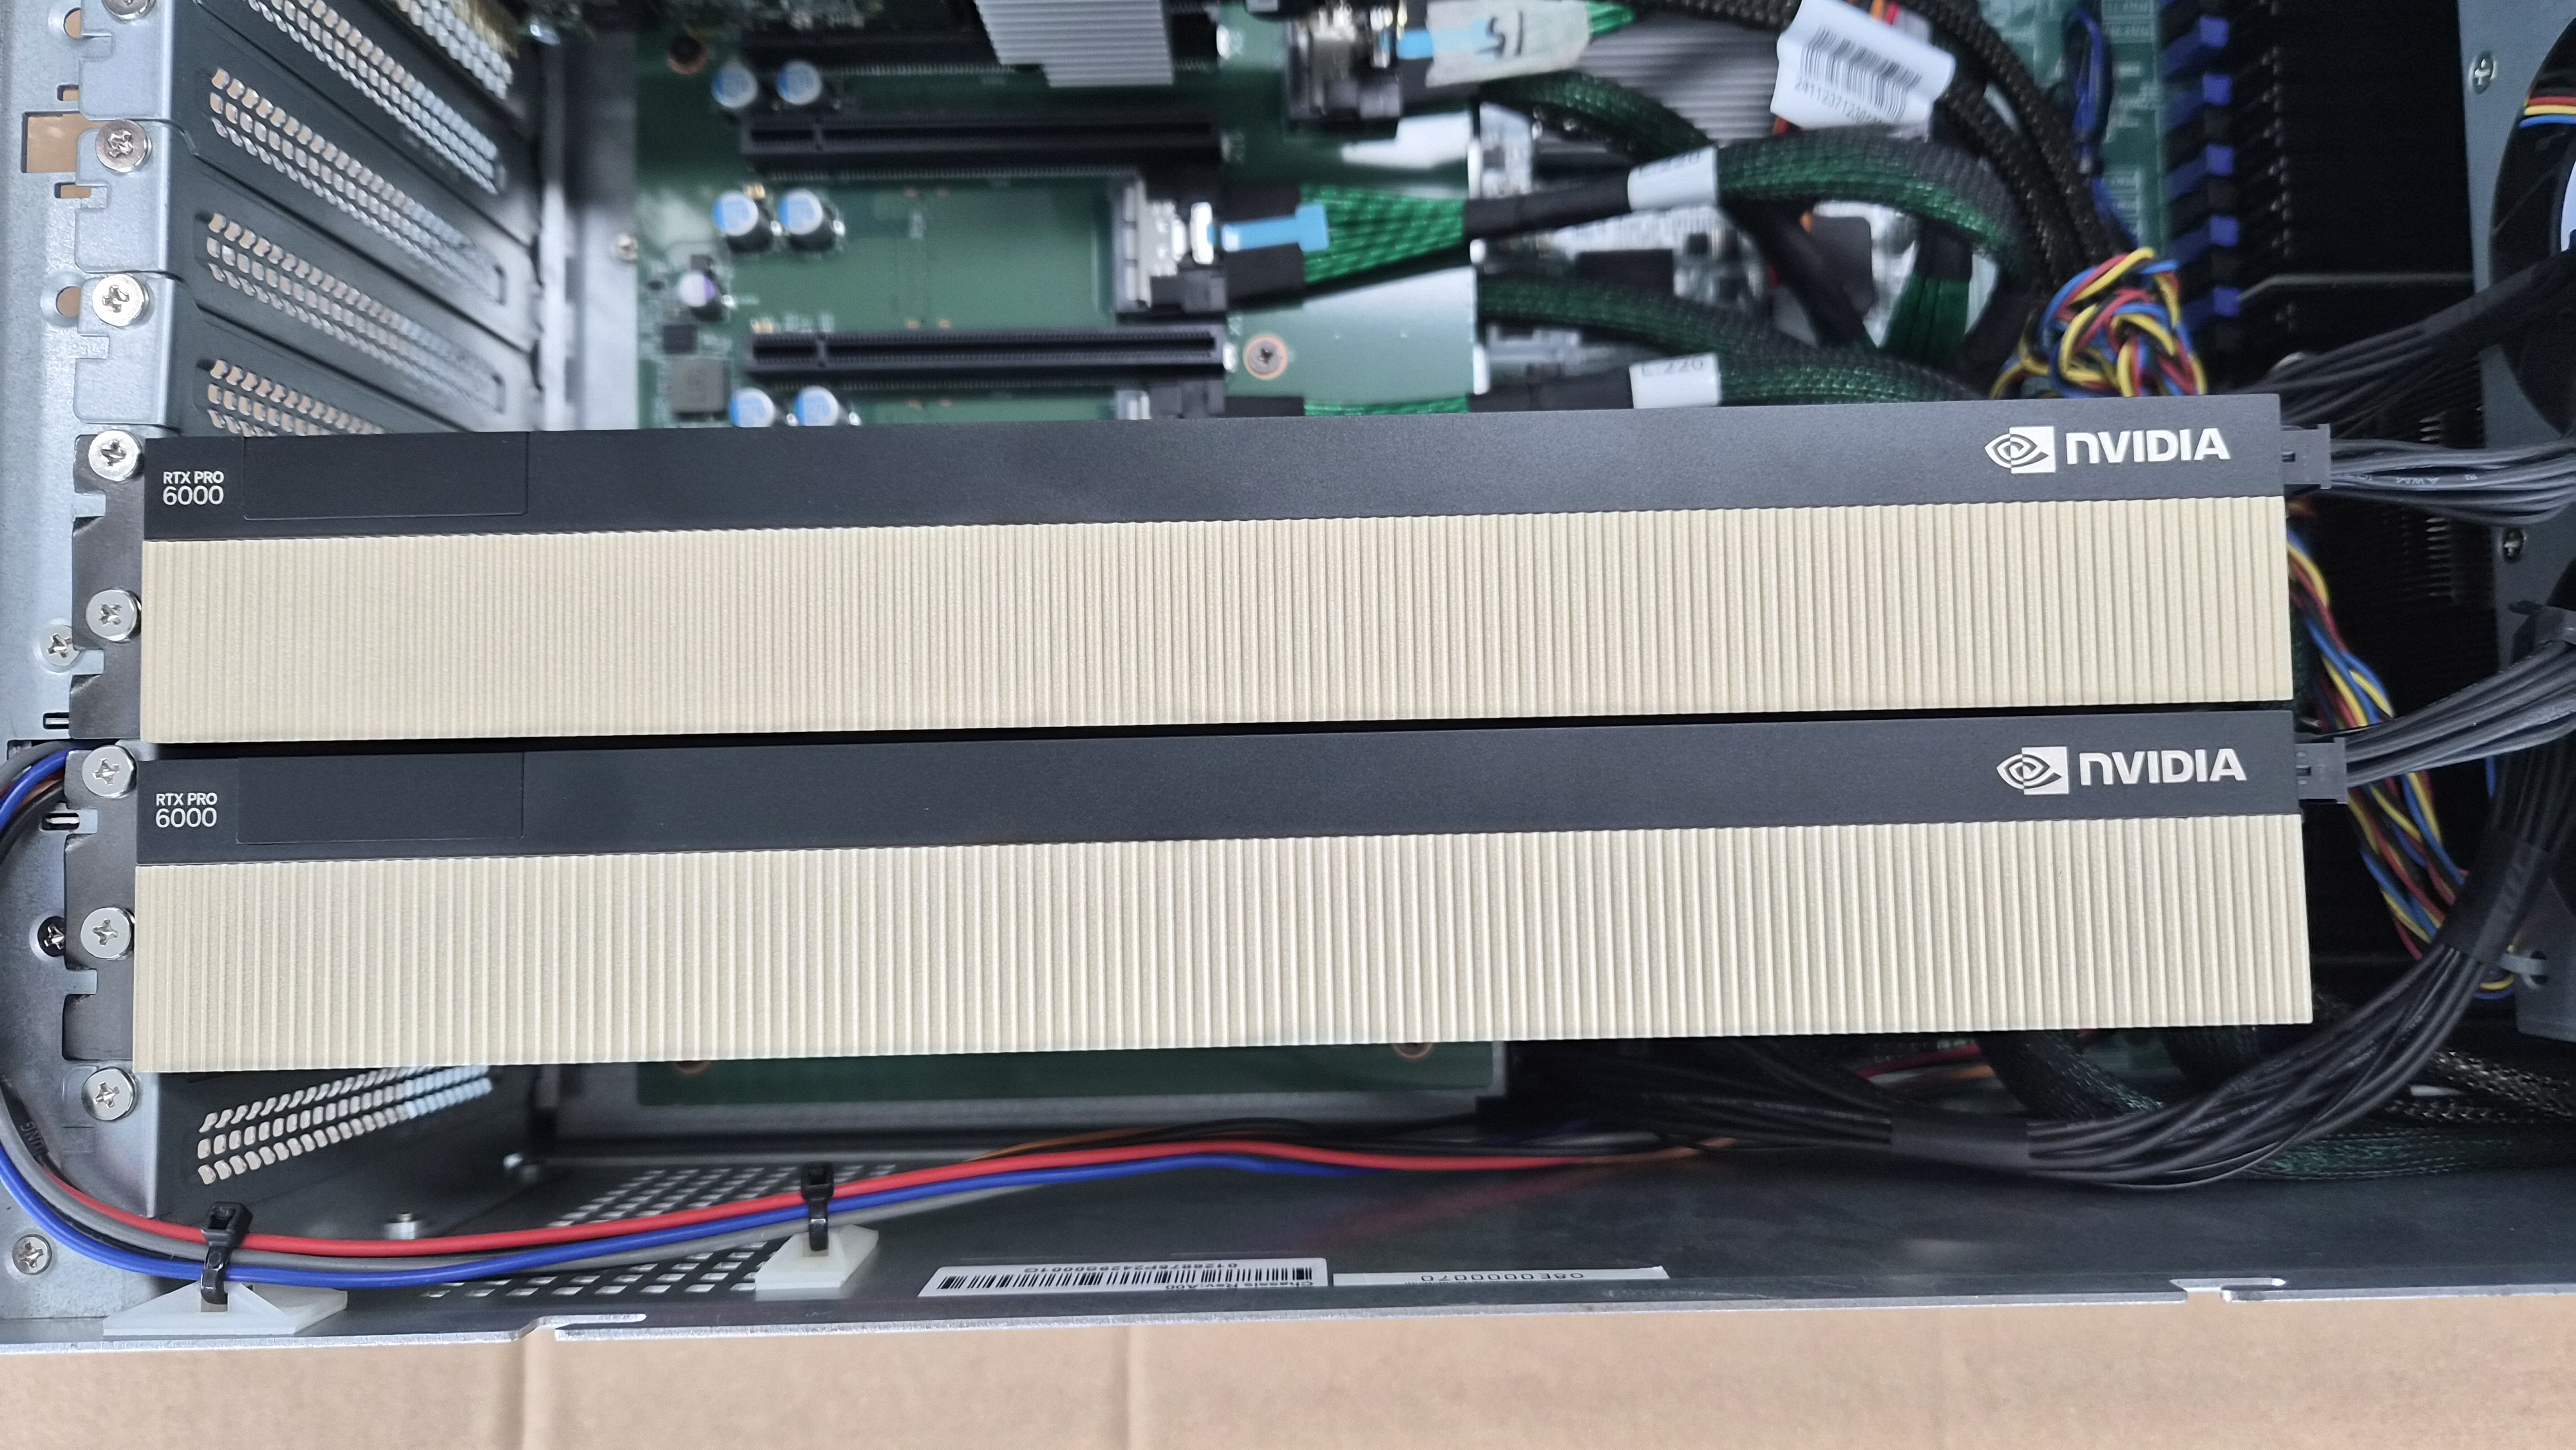
[이미지 설명] 각각 96GB VRAM을 제공하는 RTX PRO 6000 GPU 2대
2. GPU 두 장의 192GB를 어떻게 활용할까?
96GB GPU 두 장의 물리적 메모리 합계는 192GB입니다. 다만 장착만으로 하나의 GPU가 가진 192GB 메모리처럼 자동 동작하지는 않습니다.
서비스 설계에 따라 GPU별로 작업을 나누거나, 하나의 모델을 여러 GPU에 분산하는 구성을 검토할 수 있습니다. 후자의 경우 모델과 추론 소프트웨어가 지원하는 병렬 처리 방식, GPU 간 통신과 설정을 함께 확인해야 합니다. Hugging Face 역시 텐서 병렬 처리를 여러 GPU에 연산과 모델을 나누는 방법으로 설명하며 지원 모델과 구성을 안내합니다.
따라서 도입 단계에서는 목표 모델, 입력 길이, 동시 사용자 수, 목표 응답 시간을 먼저 정하고 실제 업무 조건에서 자원을 배분하는 과정이 필요합니다.
3. GPU를 뒷받침하는 CPU·메모리·SSD
이번 납품 구성은 다음과 같습니다.
| 구분 | 구성 |
| 서버 | 국산 KTNF KH590S3 |
| GPU | NVIDIA RTX PRO 6000 96GB × 2대 |
| CPU | Intel Xeon Gold 6526Y × 2개 |
| 시스템 메모리 | 64GB × 4개, 총 256GB |
| SSD | 960GB × 2개 + 1.92TB × 3개 |
| GPU 확장 | 서버 기준 최대 8개 장착 지원 |
CPU는 요청 처리와 데이터 준비 등 GPU 바깥의 작업을 담당합니다. Xeon Gold 6526Y는 5세대 Xeon Scalable 프로세서로, 1개당 16코어·32스레드, 기본 2.8GHz, 최대 터보 3.9GHz, 캐시 37.5MB, TDP 195W의 사양입니다. 이번 2소켓 구성의 합계는 32코어·64스레드입니다.
CPU 자체는 DDR5 최대 5200MT/s(1DPC), 8채널 메모리와 PCIe 5.0을 지원합니다. 이는 프로세서 지원 사양이며, 실제 장착 메모리 속도나 서버 전체 소비전력을 뜻하지 않습니다.
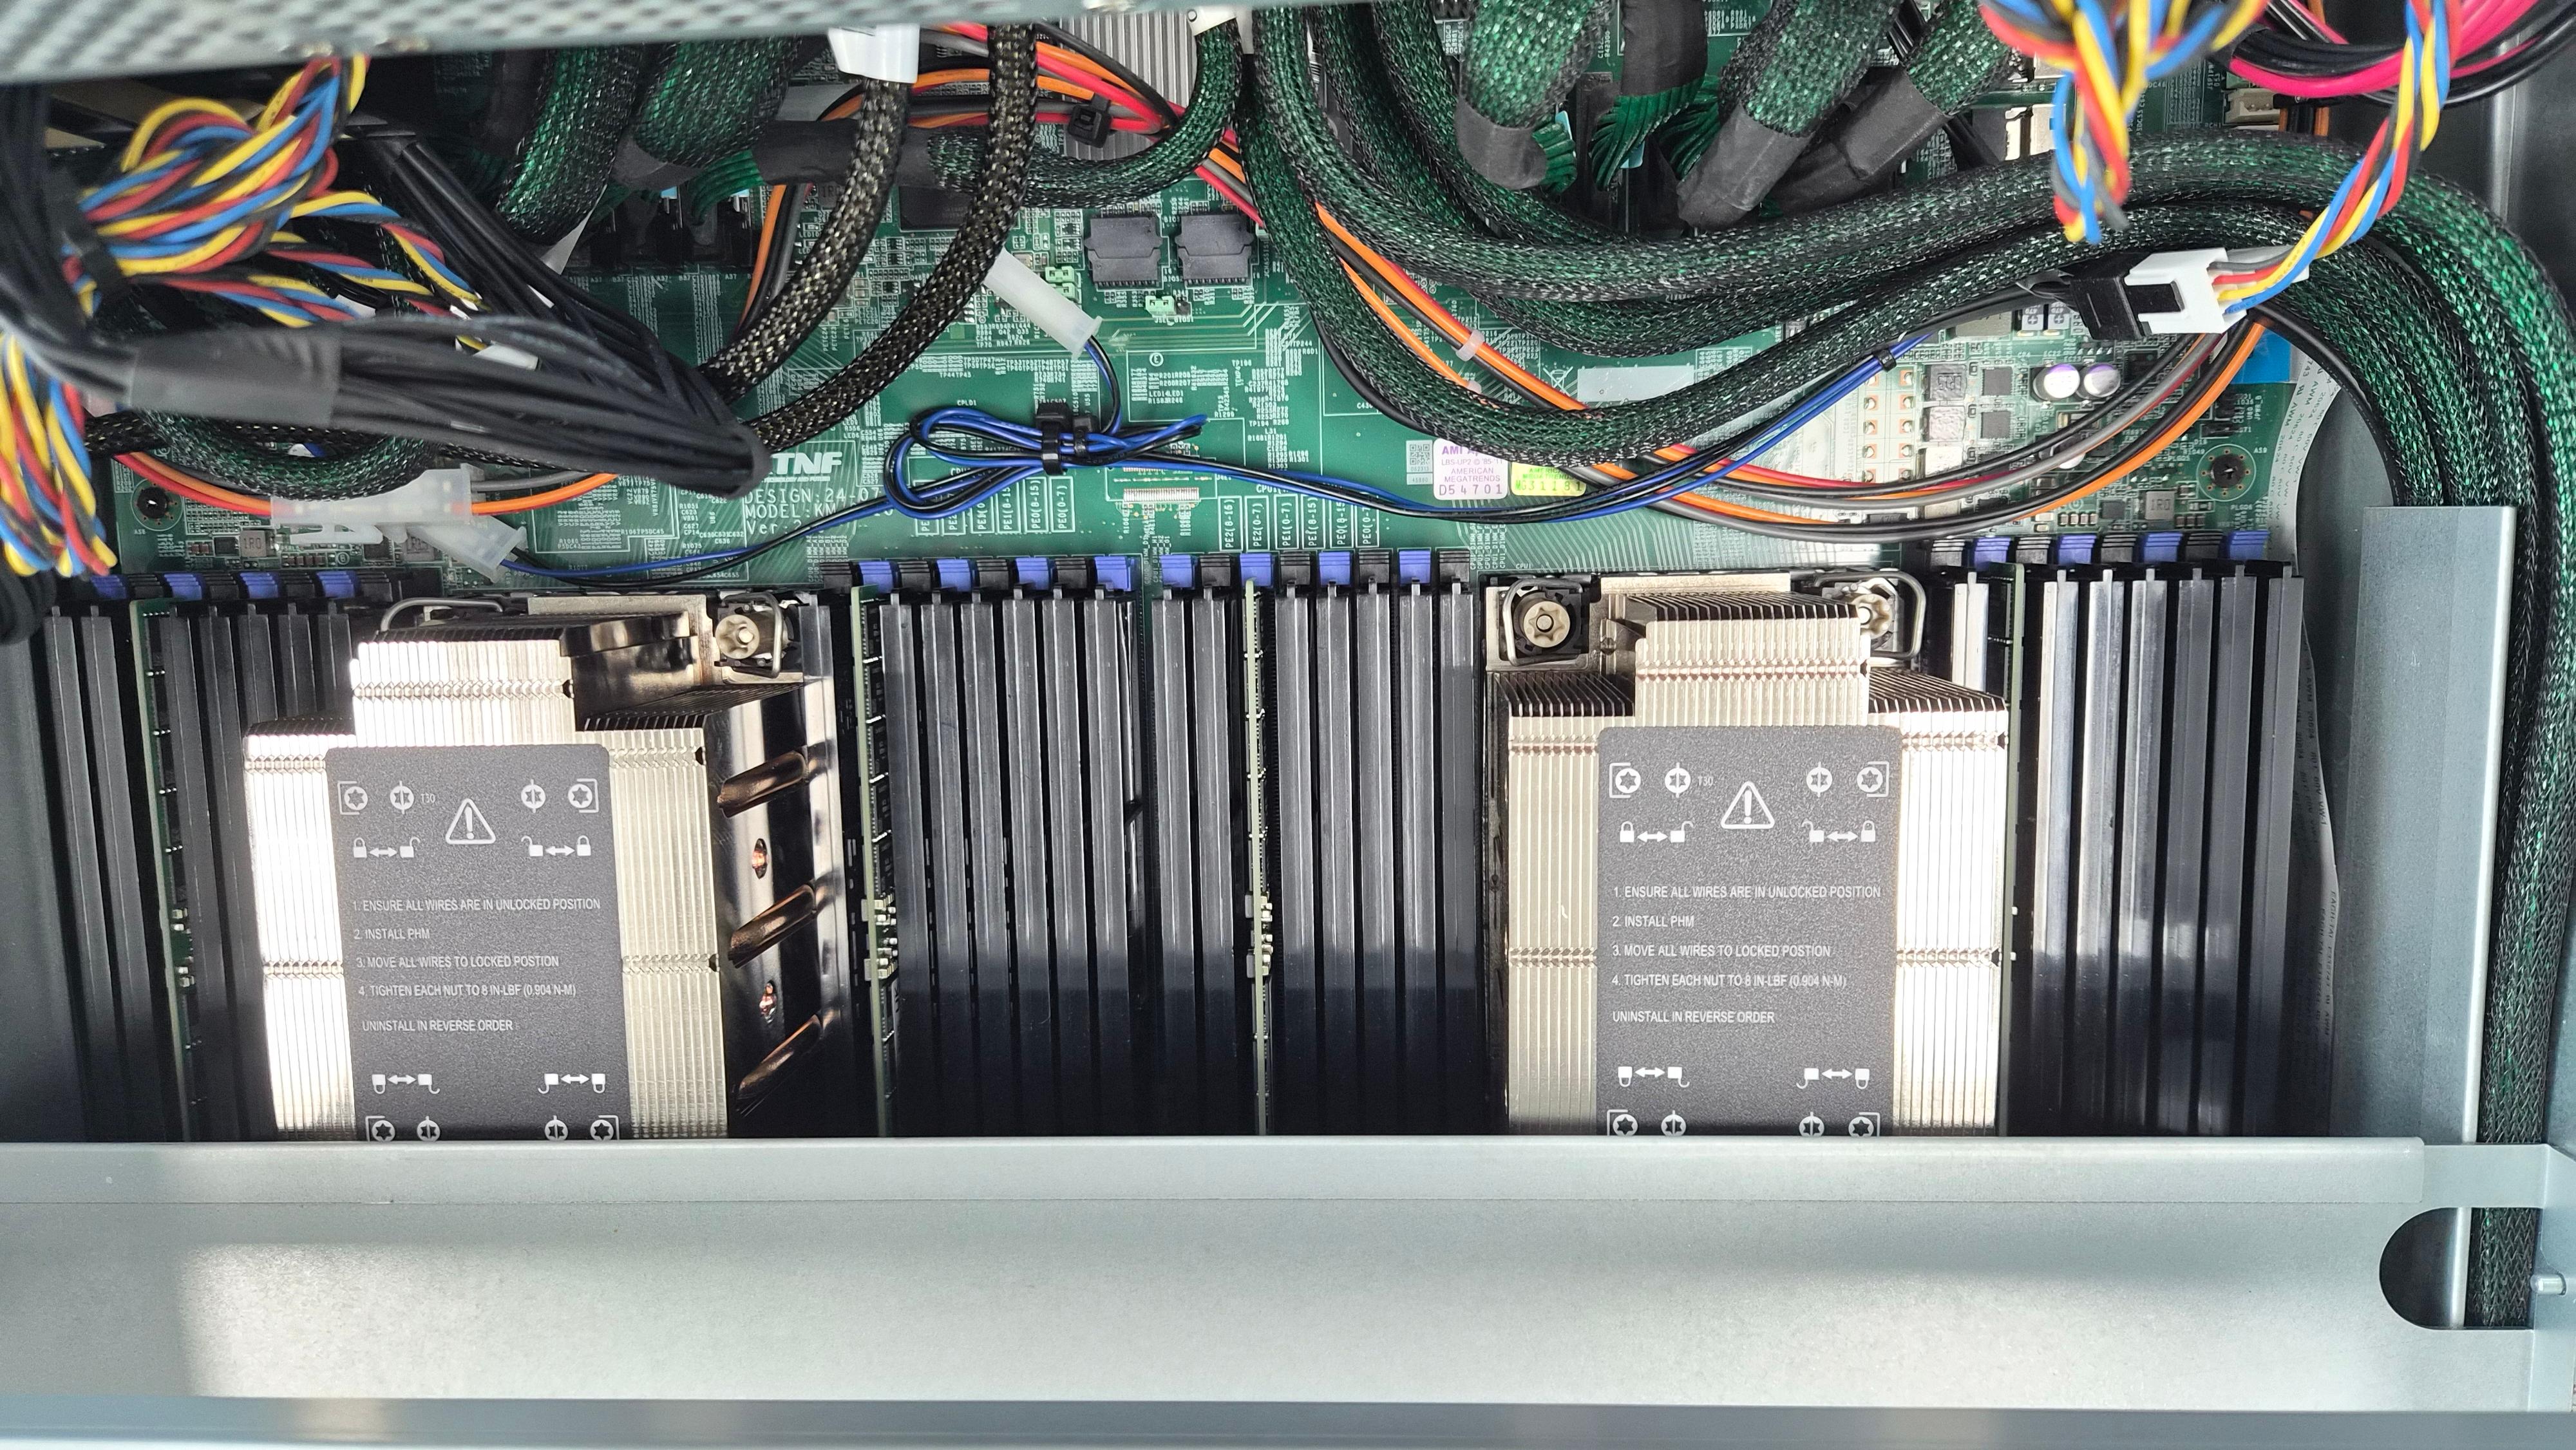
[이미지 설명] 듀얼 CPU와 시스템 메모리 영역 — GPU VRAM과 별도로 서버의 작업을 지원합니다
시스템 메모리 256GB는 운영체제와 응용프로그램, 데이터 처리 등에 쓰이며 GPU VRAM과는 구분됩니다. SSD에는 모델 파일과 업무 데이터 등을 저장할 수 있습니다. 이번 SSD 5개의 표기 용량 합계는 7.68TB이며, 실제 사용 용량은 RAID와 파일시스템 구성에 따라 달라집니다.
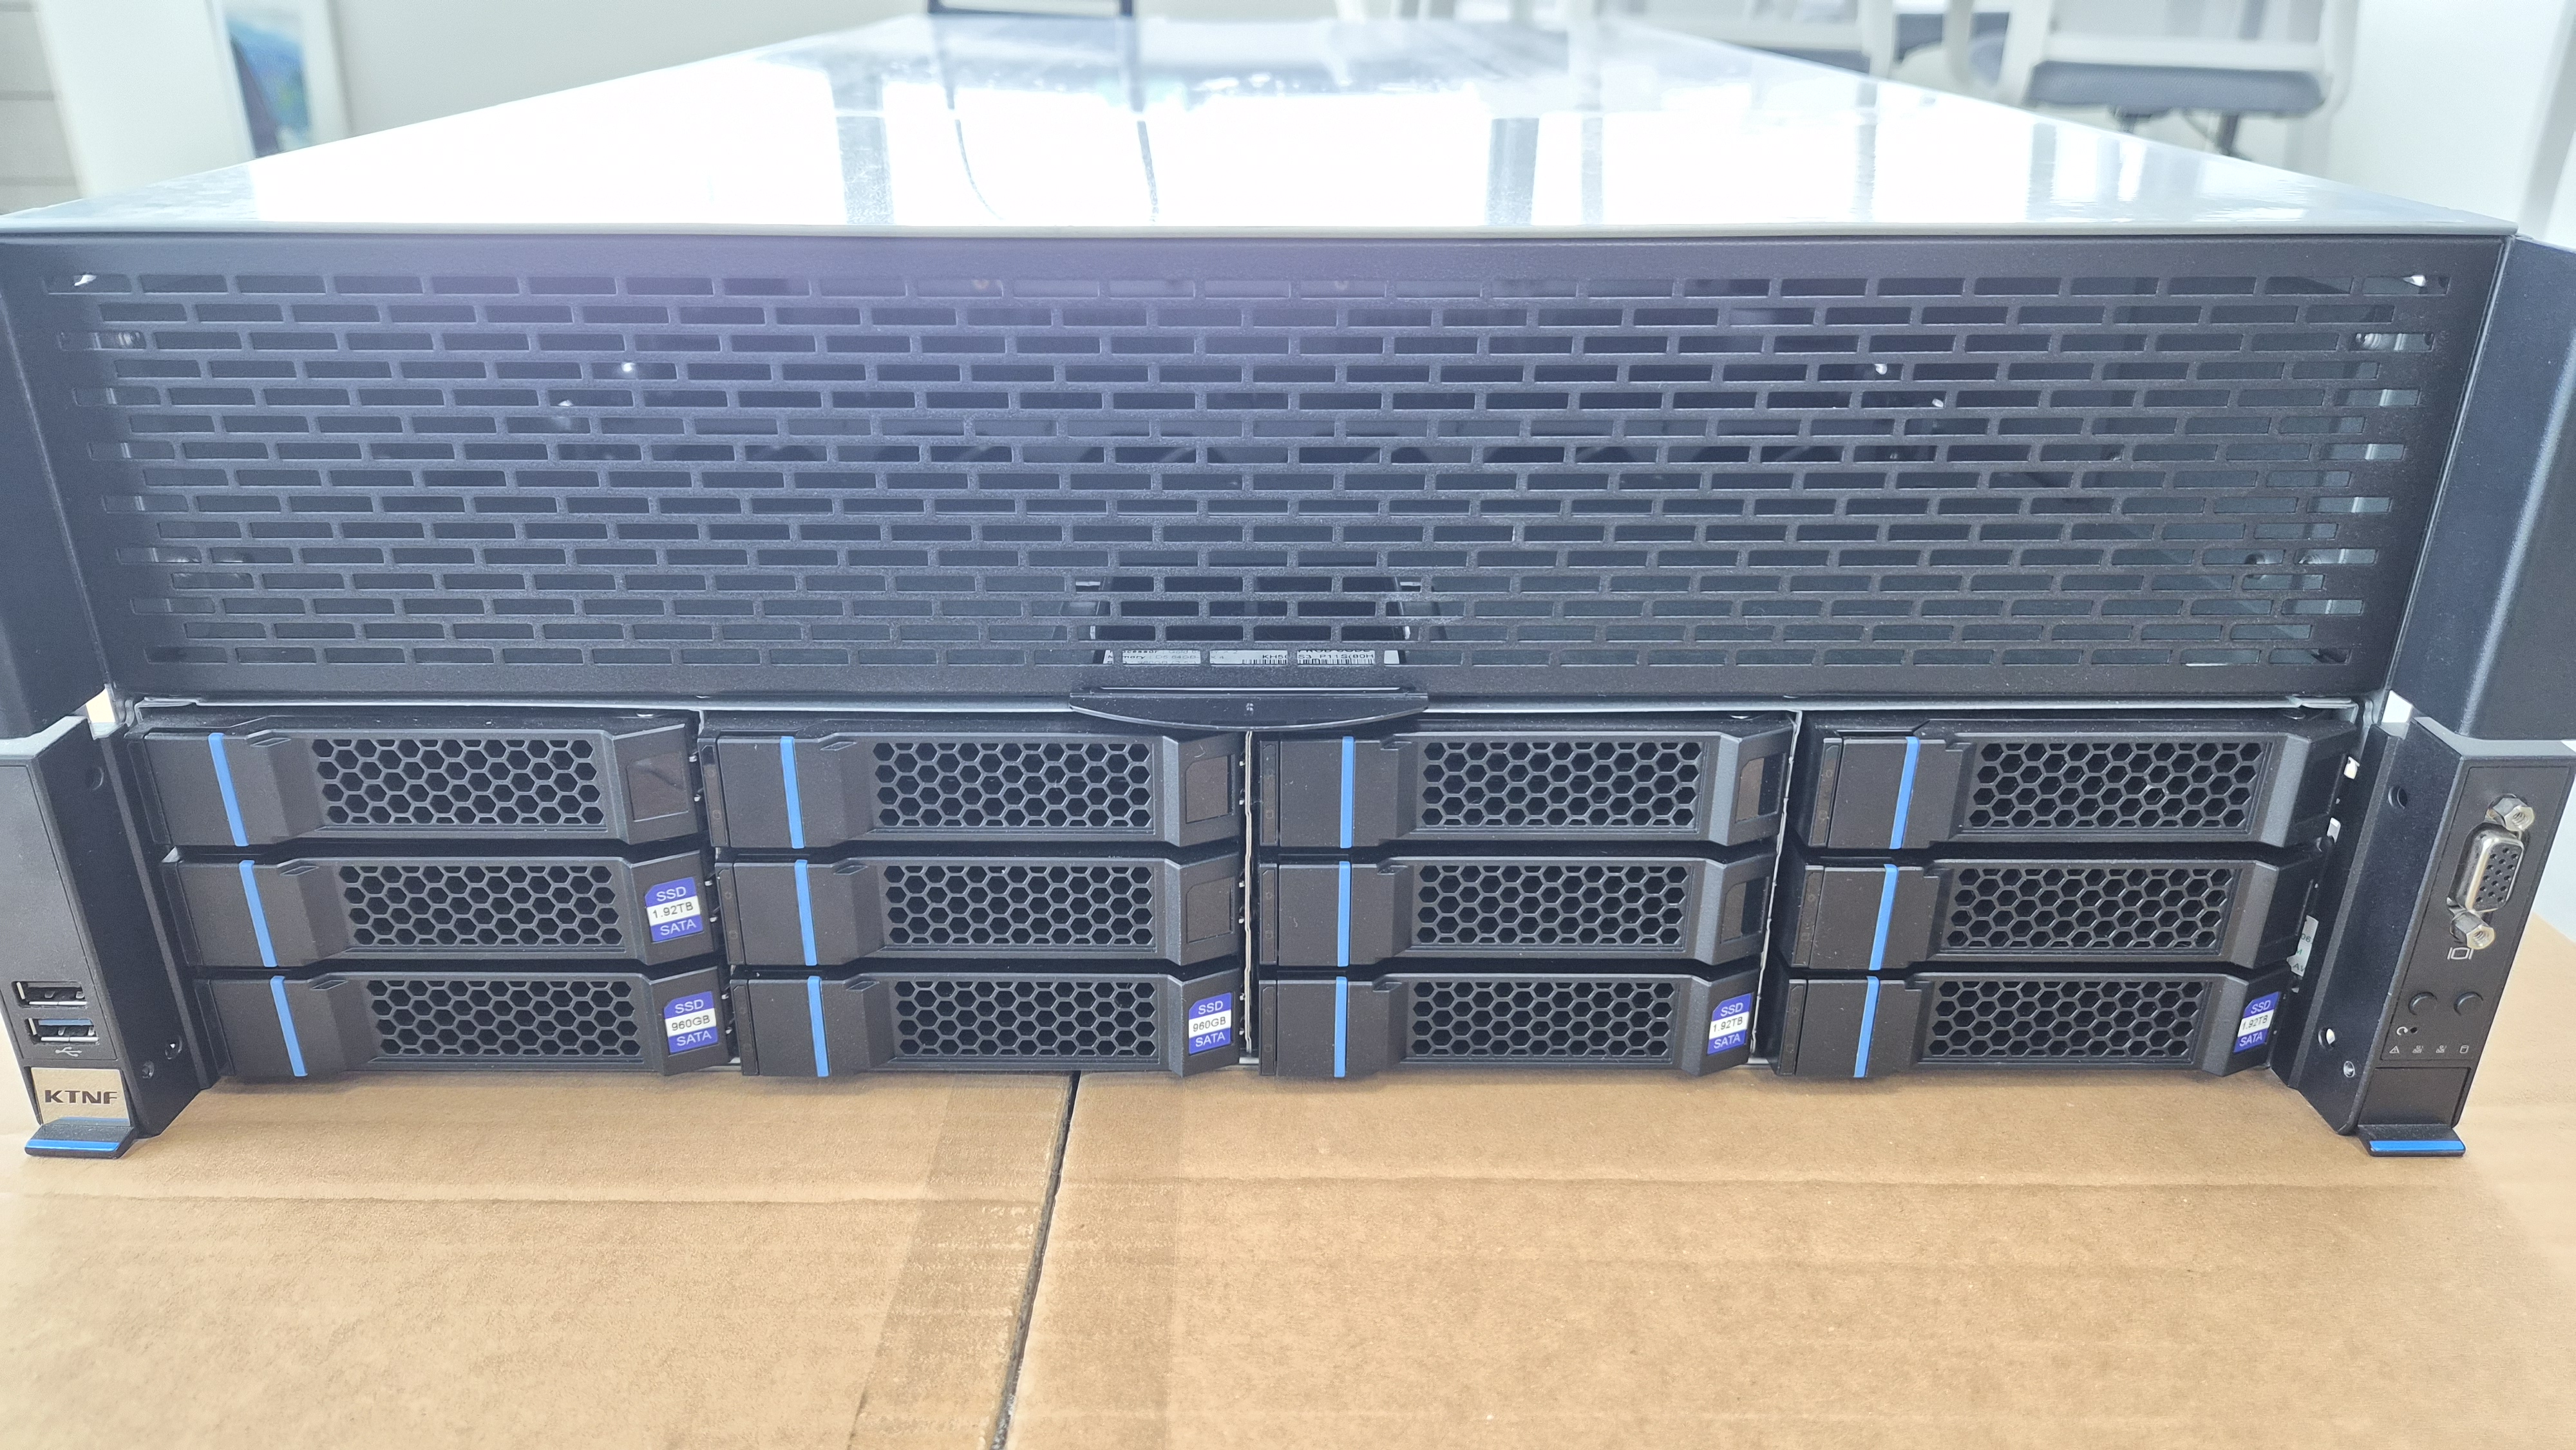
[이미지 설명] 서버 전면의 SSD 장착부 — 저장 용량과 실제 사용 용량은 구성에 따라 달라집니다
4. 최대 8개 GPU 지원, 증설 전에는 무엇을 볼까?
KTNF KH590S3는 최대 8개의 GPU 장착을 지원하는 4U 서버입니다. 현재 필요한 GPU 2대로 시작하고 업무량에 따라 확장을 검토할 수 있는 플랫폼입니다.
증설할 때는 빈 슬롯 수와 함께 지원 GPU의 크기와 소비전력, 전원 공급과 냉각 조건, 소프트웨어의 다중 GPU 활용 여부를 확인해야 합니다. 최대 장착 수가 곧 모든 GPU 조합의 지원을 의미하지는 않기 때문입니다.
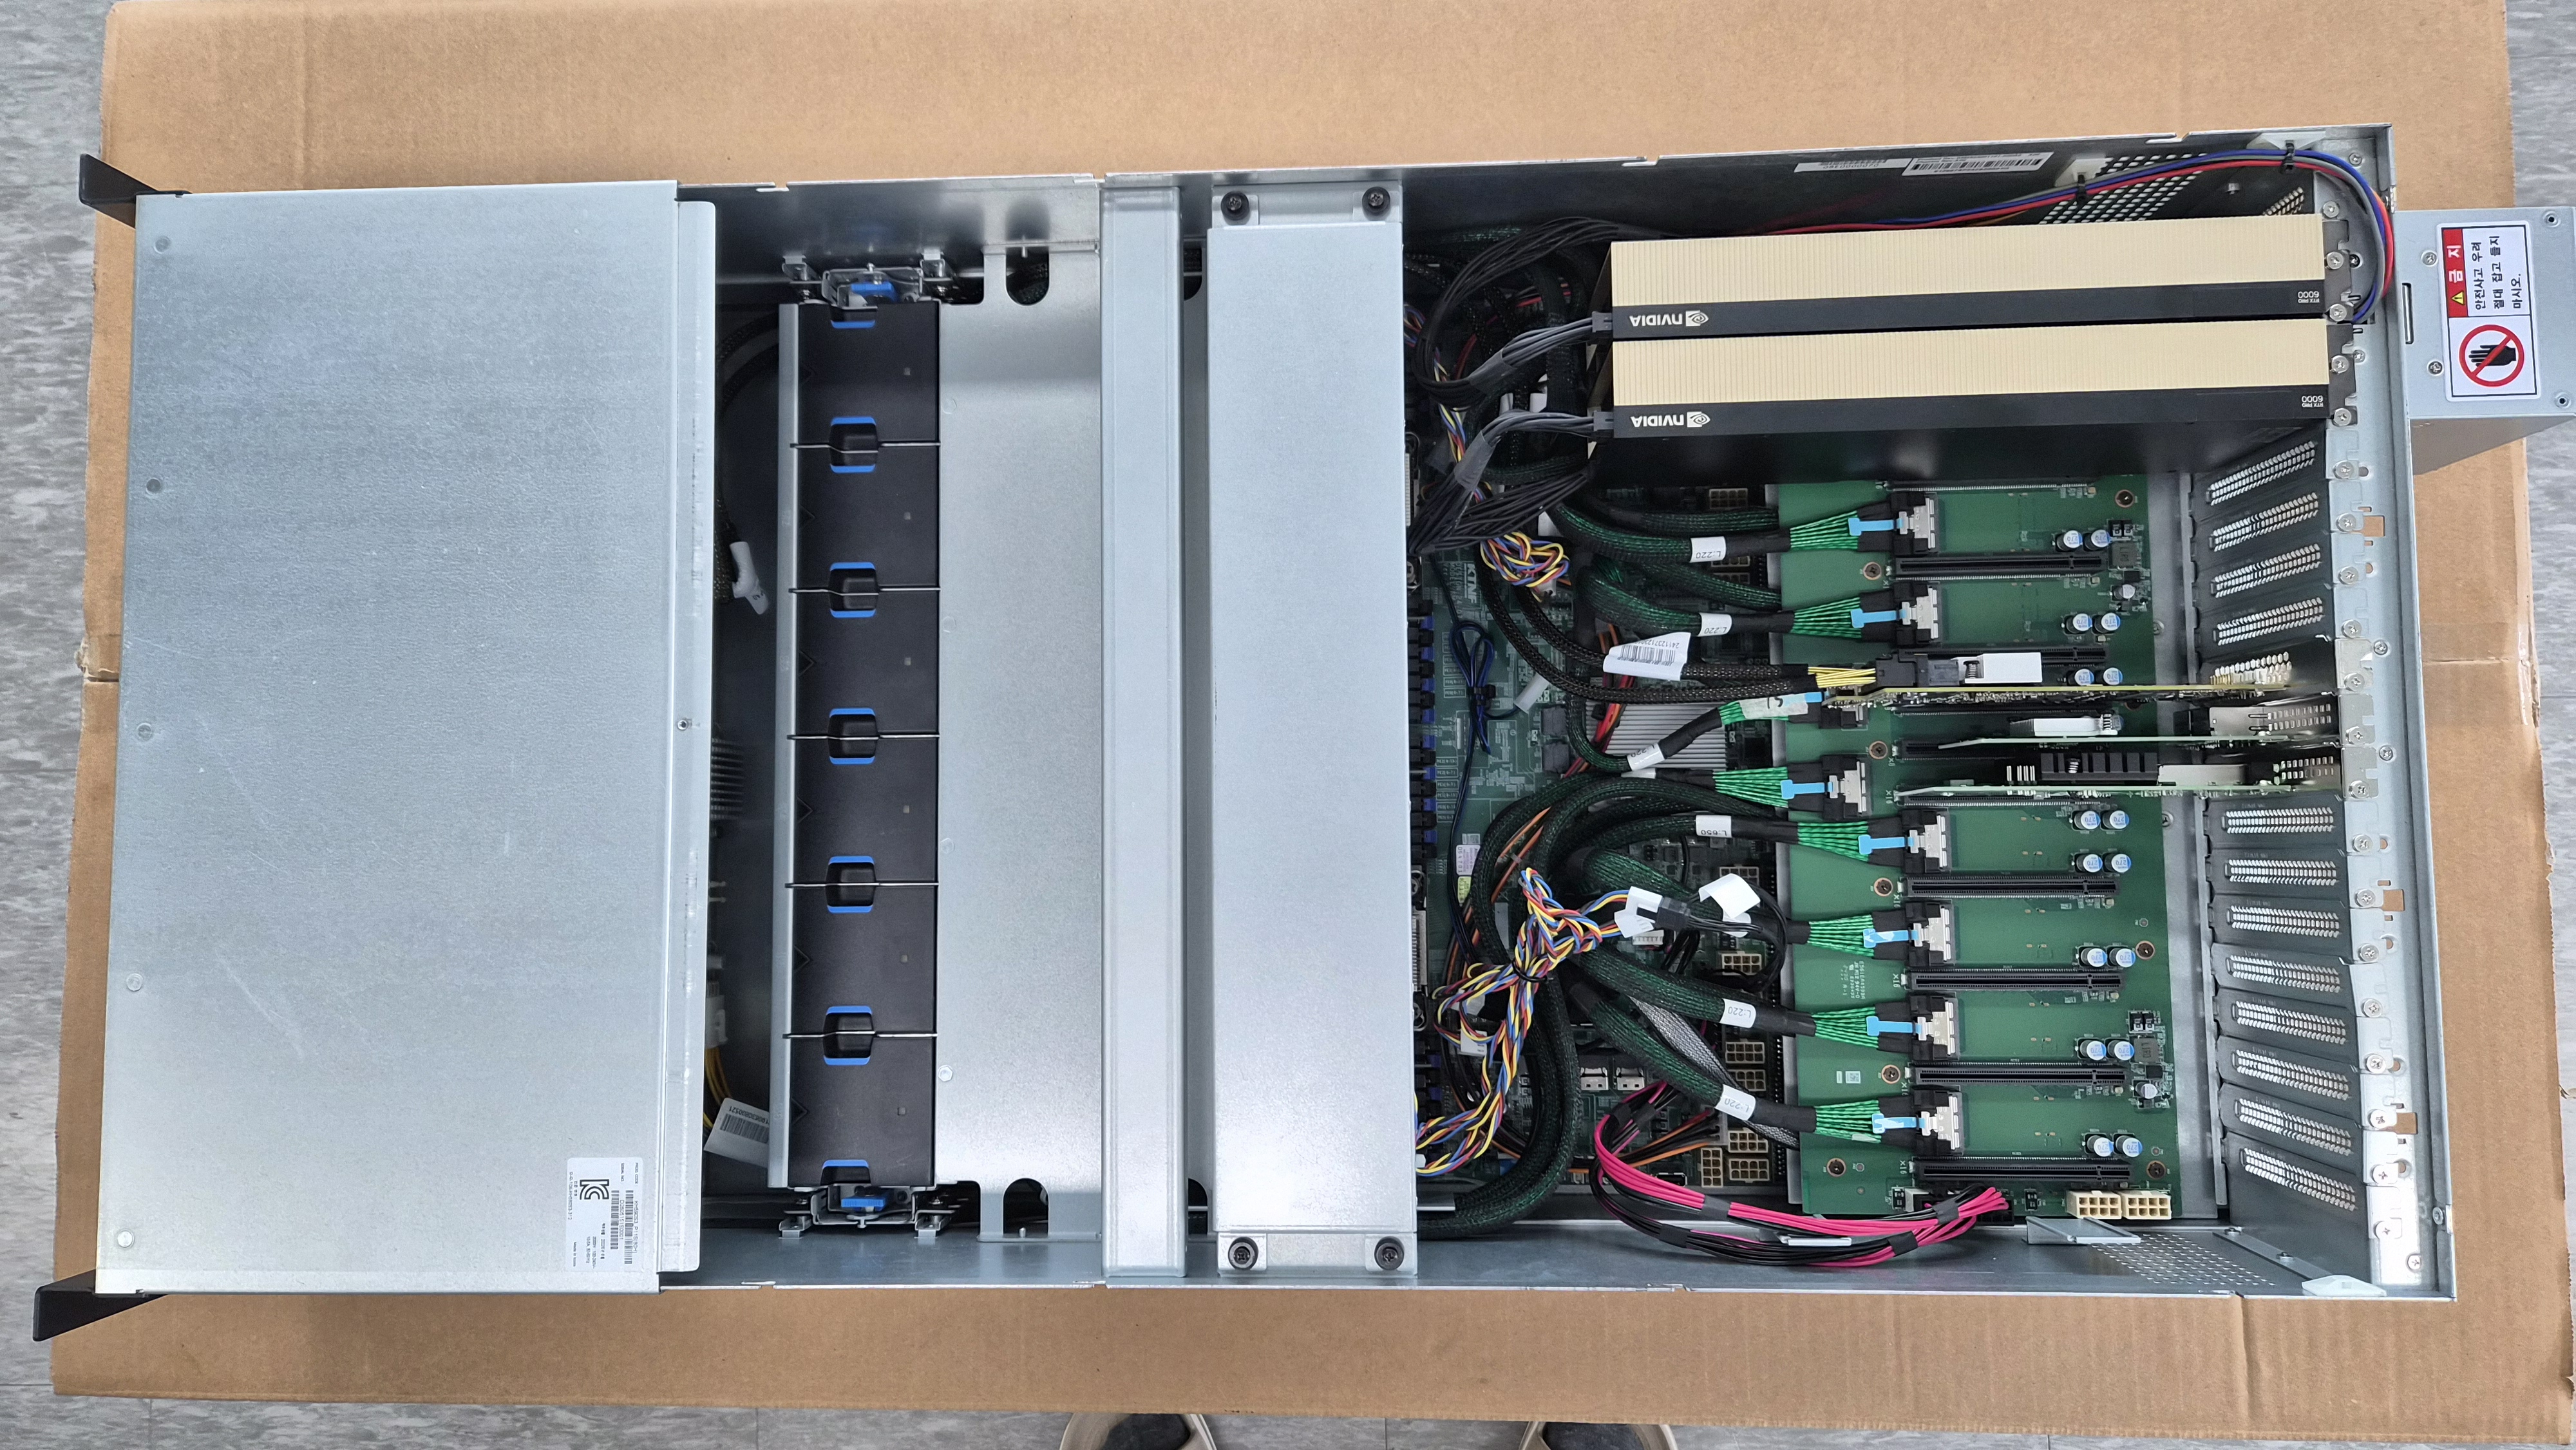
[이미지 설명] GPU 2대와 내부 확장 공간 — 증설 계획은 전원·냉각·지원 구성을 함께 확인합니다
AI 서비스와 실행 인프라를 함께 준비합니다
로컬 LLM 인프라를 계획한다면 사용할 업무와 모델, 이용 규모를 기준으로 GPU부터 저장장치까지 구성을 맞추는 것이 출발점입니다.
제로원정보기술은 AI 서비스 개발뿐 아니라 GPU 및 GPU 서버의 공급·구축도 지원합니다. 기관 내부용 AI 서버 도입, 기존 인프라의 GPU 확장, 새로운 AI 서비스 구축을 검토하고 계신다면 목적과 예산에 맞는 구성을 함께 상담해 드리겠습니다.
(주)제로원정보기술
전화: 070-8095-9791
이메일: LCH@zerooneit.co.kr
본사: 경상북도 영천시 괴연1길 24-24, 경북테크노파크 하이브리드부품연구소 304-2호
지점: 대구광역시 수성구 알파시티1로 42길 11, 태왕알파시티수성 B동 1018호
'주요사업' 카테고리의 다른 글
| 기존 GPU 서버에 H200 NVL 141GB 1대 추가 — OO테크노파크 증설 완료 사례 (0) | 2026.11.02 |
|---|---|
| 소상공인부터 프랜차이즈·기업까지, AI 홍보영상 제작과 SNS 운영을 한 번에 (0) | 2026.10.18 |
| H100 재배치와 H200 141GB 확장으로 살펴본 GPU 서버 도입 기준 (0) | 2026.09.28 |
| 시민의 질문을 홈페이지 정보로 연결하는 AI 챗봇, 영천시 운영 사례 (0) | 2026.09.28 |
| 공공기관 내부 업무에 AI를 연결하는 방법, AI주무관 v2.0 (0) | 2026.09.28 |