고정 헤더 영역

상세 컨텐츠
본문
회의록 시스템을 만들 때는 전사 정확도와 운영 조건을 함께 봐야 합니다. 이름과 숫자를 고치는 시간, 발언을 다시 찾는 시간까지 줄여야 실제 업무가 편해집니다.
Nemotron 3.5 Transcribe는 녹음과 텍스트 지시를 입력받는 Speech-Augmented Language Model입니다. 한국어 음성 처리부터 자체 서버 운영까지 검토할 때 필요한 항목을 정리했습니다.
1. 음성과 지시문을 함께 처리하는 구조
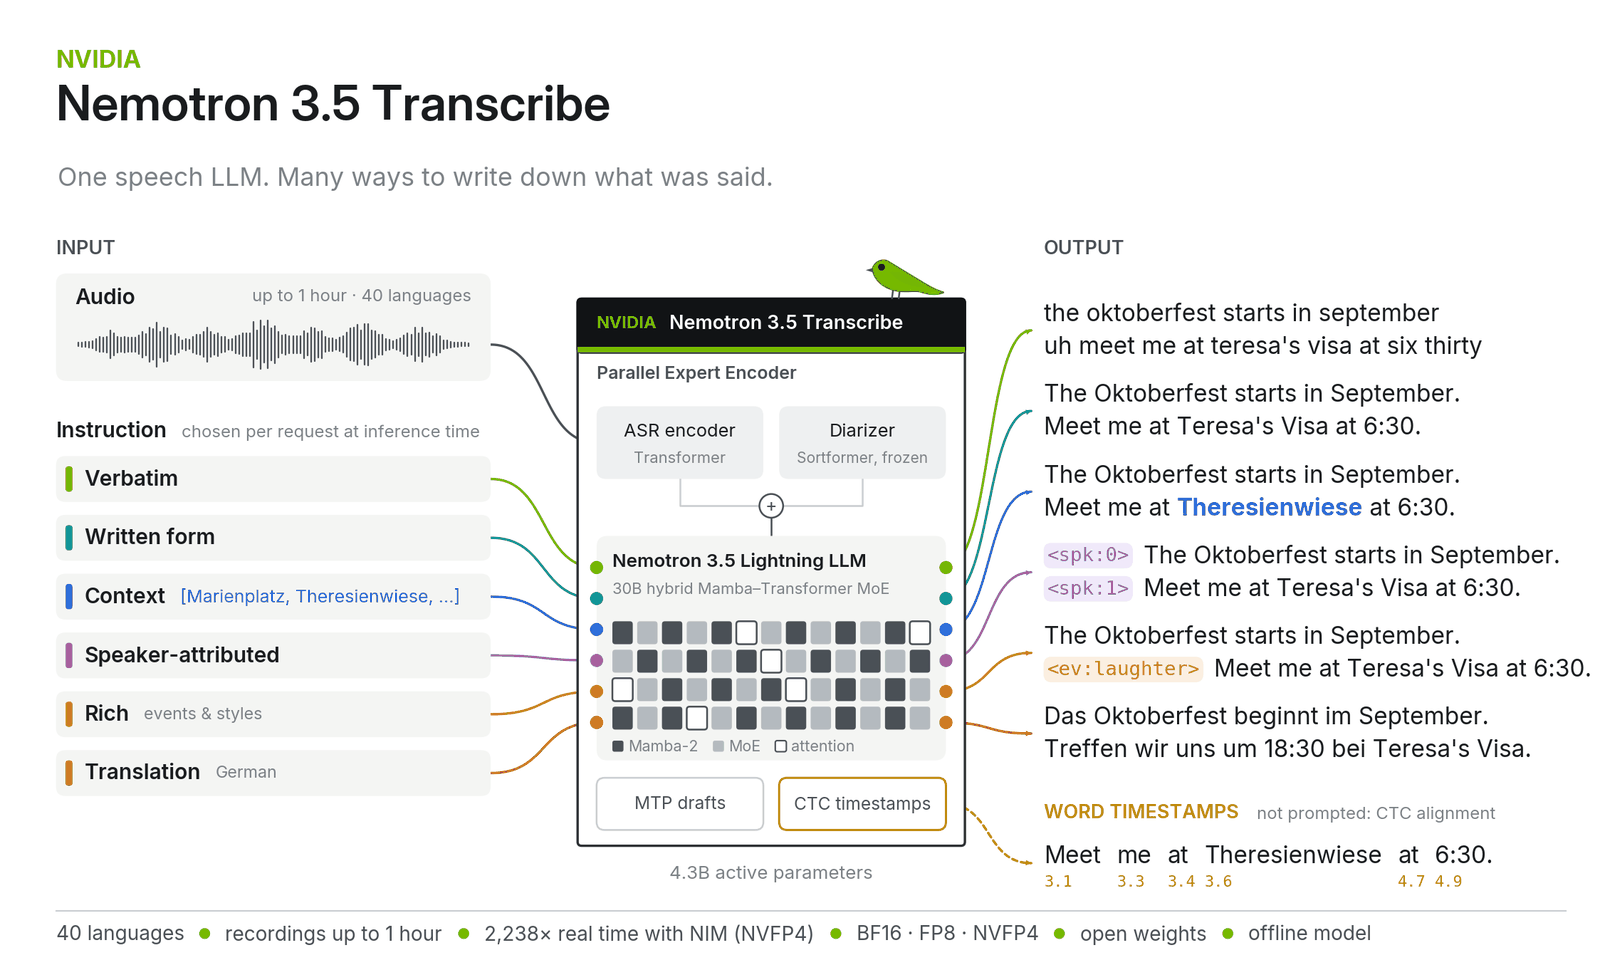
음성 인코더와 화자 구분 모듈, MoE 언어모델이 연결됩니다. 음성 인코더를 포함한 전체 파라미터는 약 34B, 활성 파라미터는 약 4.3B입니다. 활성 파라미터가 작아도 전체 가중치와 추론 메모리는 따로 확보해야 합니다.
다음은 NVIDIA의 공식 구조 개요입니다. 출력 표기나 전문용어 문맥을 지시문으로 조절할 수 있어, 하나의 고정 받아쓰기 규칙보다 업무에 맞춘 설정 여지가 큽니다.
2. 전사와 후속 문서 작성을 분리해서 설계하기
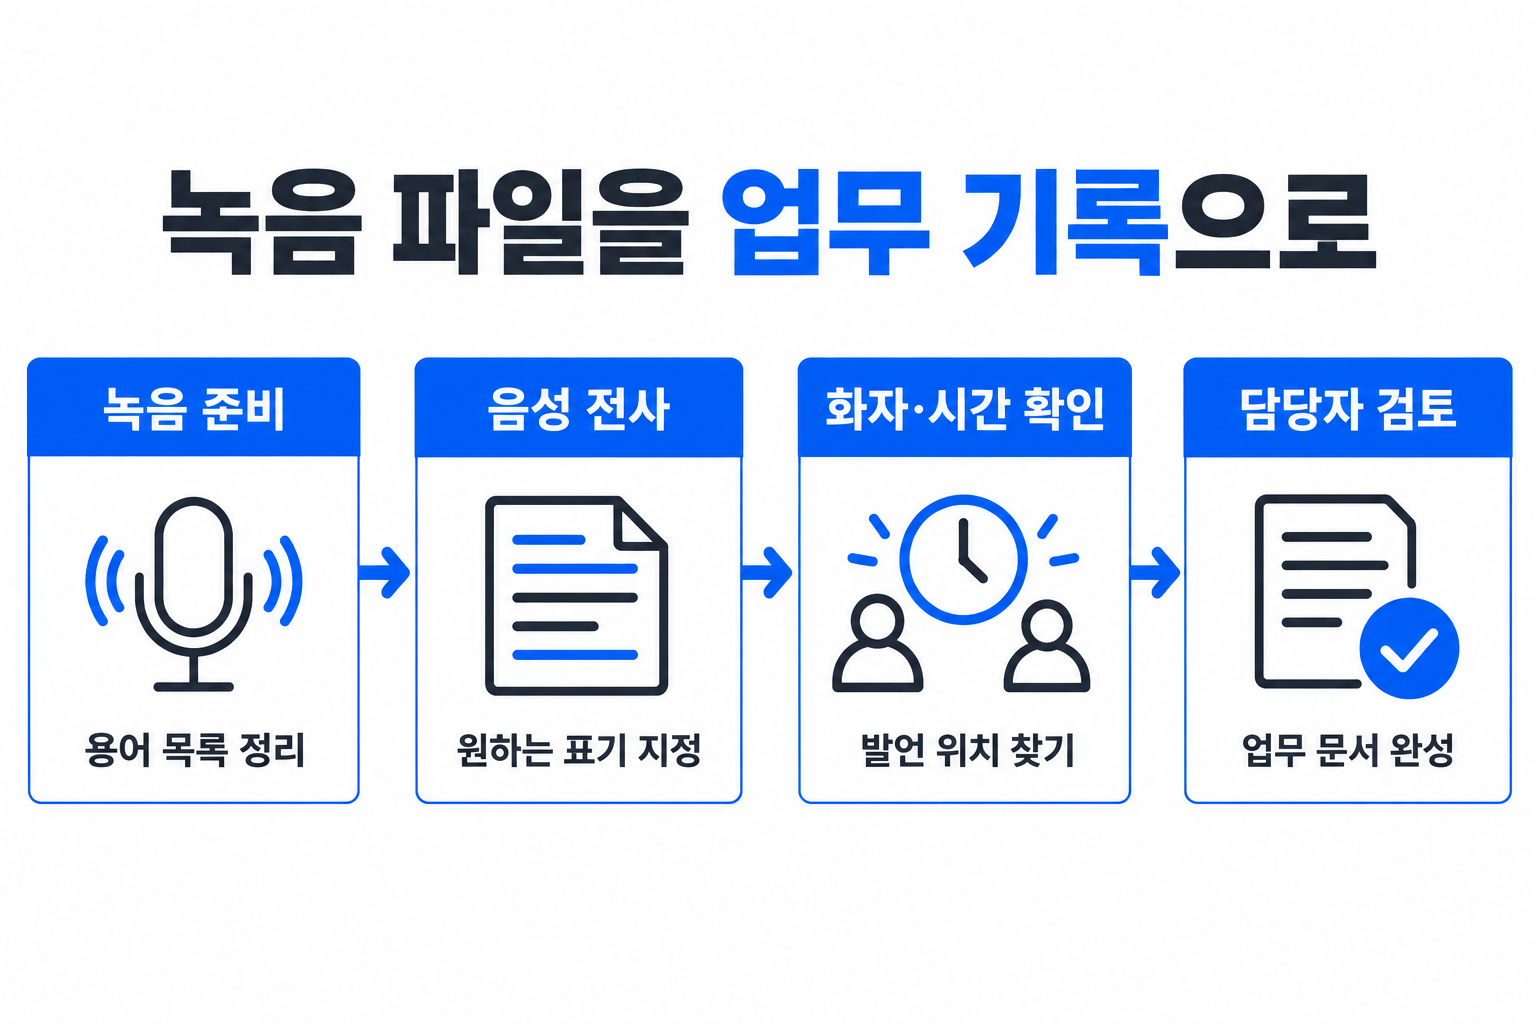
우선 원문 보존용 전사와 읽기 좋은 기록 중 무엇을 만들지 정하세요. 화자 태그와 시간 정보가 필요한 작업이라면 요청 단계부터 포함하고, 이름·부서·제품명 목록을 문맥으로 전달합니다.
예를 들어 고객 상담 녹음을 처리할 때는 상담 내용의 원문 기록을 먼저 확보하고, 담당자가 약속한 일정과 금액을 원음으로 확인한 뒤 별도 요약 단계에서 업무 티켓을 만드는 흐름이 적합합니다. 전사 기록과 요약 결과를 함께 보관하면 수정 근거를 찾기 쉽습니다.
3. GPU와 입력 한도를 먼저 맞추세요
공식 BF16 시작 예제는 H100 80GB 한 장을 기준으로 합니다. FP8·NVFP4 등 다른 정밀도는 GPU 호환성과 지원 경로를 확인해 선택하세요. 최대 녹음 길이는 1시간, 문맥 길이는 65,536토큰입니다.
한국어는 전사·번역·다중 화자 처리 지원표에 포함되지만, 음성 이해와 추론 평가는 영어 기준입니다. 한국어 회의 Q&A까지 한 번에 도입하려면 별도 검증이 필요합니다. 내부 오디오 분할 기능을 실시간 스트리밍 지원으로 해석하지 않도록 주의하세요.
4. 작은 검증 세트로 처리 품질을 비교하세요
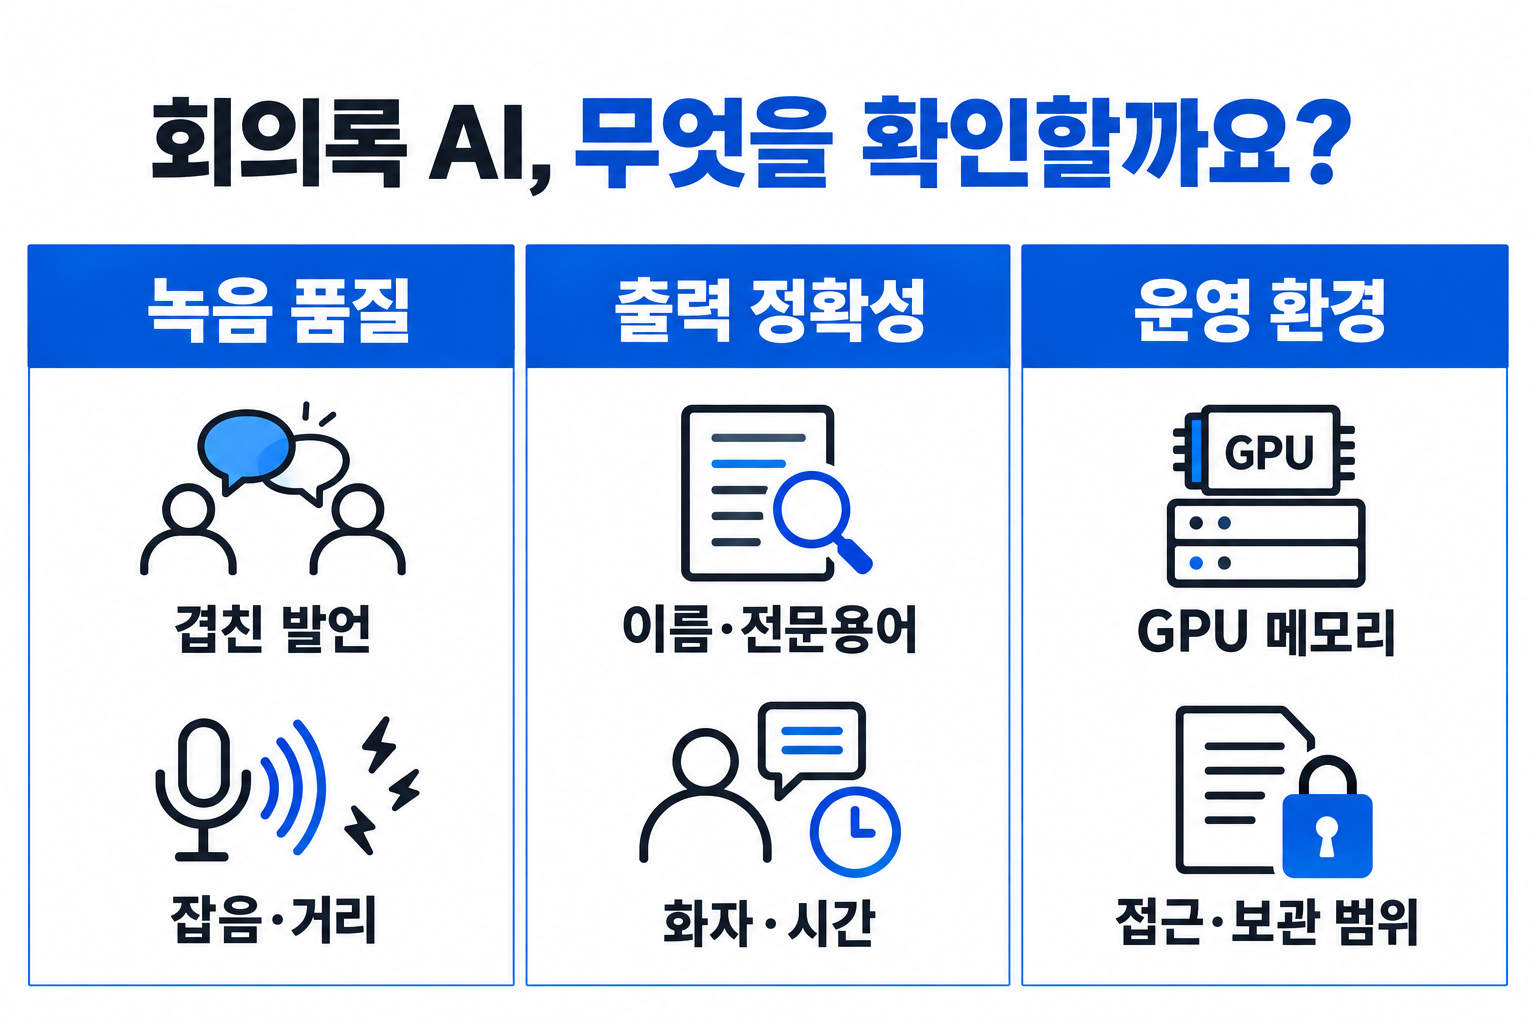
발언이 겹치는 회의, 전문용어가 많은 회의, 잡음이 있는 회의를 각각 골라 기준 전사본을 만들어 보세요. 단어 오류율과 함께 화자 오류, 숫자 오류, 담당자의 수정 시간을 기록하면 도입 판단에 도움이 됩니다.
운영 비용은 GPU 사용 시간에 검토·보관 비용을 더해 계산하는 편이 현실적입니다. 최적화된 NIM의 처리량을 일반 오픈소스 설치 성능으로 가정하지 말고, 사용할 정밀도와 동시 처리 조건에서 측정하세요.
공식 출처·참고 자료
(주)제로원정보기술
AI 서비스 개발부터 GPU 서버 공급과 IT 인프라 구축까지 지원합니다.
주요 사업
AI 챗봇 · 내부 업무용 AI 서비스 · GPU 및 GPU 서버 공급 · 서버·클라우드 인프라 구축
상담 및 구축 문의
전화: 070-8095-9791
이메일: LCH@zerooneit.co.kr
본사: 경상북도 영천시 괴연1길 24-24, 경북테크노파크 하이브리드부품연구소 304-2호
지점: 대구광역시 수성구 알파시티1로 42길 11, 태왕알파시티수성 B동 1018호
'기술자료' 카테고리의 다른 글
| Gemini Agent 실행 구조: 클라우드 지속 작업·연결 도구·승인과 완료 기준 (0) | 2026.11.01 |
|---|---|
| 노마디안 업무 설계 가이드: 역할 분담·산출물 인계·승인 지점 정하기 (1) | 2026.10.31 |
| Devin Security 2.0 운영 가이드: 위협 모델·재현 환경·수정 PR 검토 기준 (0) | 2026.10.29 |
| Siri AI 한국어 베타 활용 가이드: iOS 27.2 지원 기기·설정·업무 접근 범위 (0) | 2026.10.28 |
| RTX 30 GPU Unlock 성능 해석: BF16 연산 개선과 LLM·영상 생성의 병목 차이 (0) | 2026.10.27 |